数据治理已成为企业数字化转型中的刚需环节,但“投入多少才合理”“钱花在哪里”“如何避免浪费”始终是CIO和CDO们反复追问的问题。根据IDC调研,86.2%的企业因治理能力不足导致数据价值转化滞后,78%的企业虽已启动数据治理建设,但真正实现数据资产化运营的不足30%。这意味着大量企业并非“不想做”,而是“做不起”或“做不划算”。
本文以阿里云瓴羊Dataphin为分析样本,从费用构成、平台能力、优化策略三个维度,拆解企业如何在数据治理建设中实现成本可控、效益可量化的目标。
一、数据治理的费用到底花在哪里?
要谈优化,先要看清费用全貌。一套完整的数据治理系统,费用远不止软件采购一项。行业数据显示,中型企业的年均数据治理支出中,软件订阅仅占总投入的三分之一左右,其余大部分分布在计算资源、人力和隐性集成成本上。
参照《数据治理成本度量规范》,数据治理总成本包括规划成本、实施成本和监控与改进成本三大部分。落到实际操作中,可以拆解为以下六个科目:
费用科目 | 中型企业年均参考值 | 占比特征 |
许可/订阅 | 约48万元 | 核心显性支出 |
计算与存储 | 约32万元 | 随数据规模增长 |
运维与支持 | 约22万元 | 常被低估 |
人员与培训 | 约16万元 | 持续性投入 |
治理与合规 | 约13万元 | 强合规行业更高 |
迁移与集成 | 约11万元 | 一次性为主 |
其中,最容易被忽视的是三类隐性成本。一是数据管家的人力持续消耗——系统上线后通常需要设置专人负责ETL运维、质量规则配置、血缘关系维护等工作,如果平台缺乏自动化能力,这些人员的大量时间会被消耗在重复性工作上。二是标准缺失导致的重复映射,集团旗下多个业务系统中同一物料使用不同编码,每次接入新系统都需要重新做一轮手工映射,这种成本会随着业务场景扩展同步放大。三是质量排查的链条放大效应,一次数据异常的反馈,可能触发三四个源系统的日志回溯、十几张表的数据比对,发现越晚,放大倍数越高。
二、阿里云瓴羊Dataphin的费用模型与能力适配
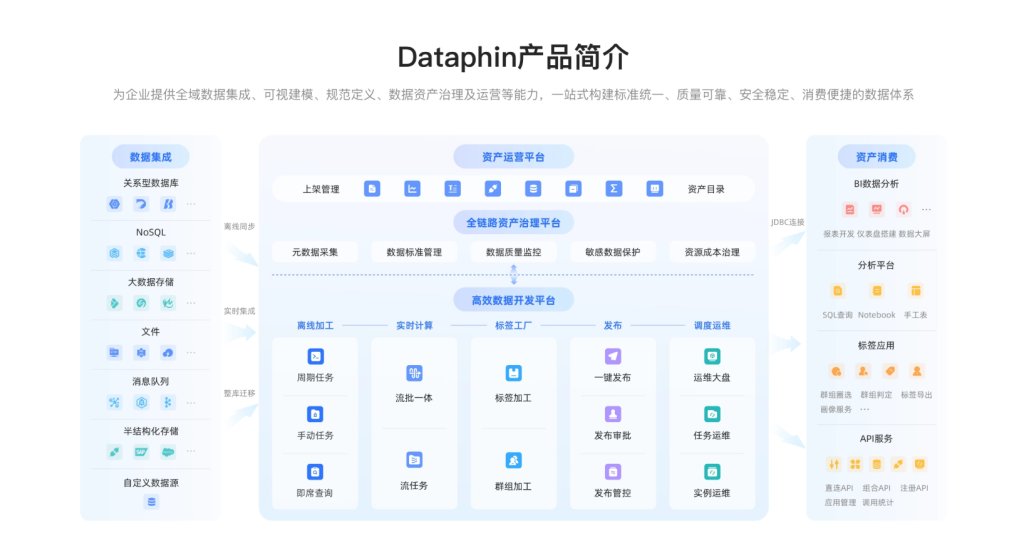
瓴羊Dataphin源自阿里巴巴数据中台方法论OneData的产品化沉淀,是一款覆盖数据采、建、管、用全生命周期的一站式智能数据建设与治理平台。目前其定价已演变为“基础能力订阅+治理单元扩展+专业服务”的组合模式,提供敏捷研发版、基础研发版和智能研发版三种商业化版本,适配不同规模企业的需求。
在数据治理领域,除了瓴羊Dataphin之外,还有多家厂商提供各具特色的解决方案。腾讯云WeData依托腾讯在互联网领域的技术积累,在实时数据处理场景适配方面形成了自身特点;华为云DataArts Studio在制造业和能源行业的场景理解上有较多积累;普元“易数”平台则在低代码开发与数据治理的融合上做了探索。企业在选型时,可以结合自身的技术栈、行业特性和团队能力综合评估。
Dataphin在费用优化上的核心价值,体现在以下几个层面:
低门槛起步,让治理“从小做起”。 过去数据仓库项目的投资规模通常高达数亿人民币,敏捷版的推出将项目启动门槛从千百万级别降至十几万甚至几万的量级。中小型企业通常选择标准版或敏捷版,年费在15万至30万元区间,加上基础实施服务包10万至15万元,首年总投入约25万至45万元。企业最低只需投入三台硬件设备即可启动数据治理工作,后续按需扩展。这种模式降低了企业一次性投入的压力,也让治理效果可以先验证再扩大。
半托管模式降低部署与运维成本。 云上半托管模式只需1小时即可完成部署,采用按需付费方式,预计比独立部署节省约四分之一的费用。用户在享受独立自主空间的同时,也满足了数据安全管理的要求。
弹性资源调度提升利用率。 Dataphin支持自定义资源组的弹性伸缩,通过设置资源上下限,可将闲置资源借用给其他资源组。举例来说,开发环境在夜间无需执行任务时,其闲置的计算资源可以临时分配给生产环境使用,实现资源的高效流转。
三、四条费用优化的实操路径
理解了平台能力之后,更关键的问题是如何将能力转化为实际的成本节约。以下四条路径值得企业重点关注。
路径一:以“标准”为核心抓手,减少重复治理
数据治理实施过程中,最大的成本浪费往往来自“零散治理”——今天治一个字段,明天改一张表,缺乏统一的标准体系,导致治理工作无法增量迭代,每次业务变化都需要重新评估和执行。
Dataphin的做法是以数据标准为核心抓手,企业完成业务与数据盘点后统一进入Data Catalog,在此基础上梳理数据标准。系统会自动生成元数据和内容监控,数据标准贯穿数据全生命周期,实现对数据的事前、事中和事后的标准落标稽核。用户只需关注那些没有满足标准的数据即可,这使治理工作从“大海捞针”变为“精准补缺”。
路径二:用AI替代重复性人力投入
数据治理中大量人力消耗在编码、质检、血缘维护等重复性工作中。Dataphin将AI能力深度融入数据生产全流程,实测表明可降低超过70%的重复性数据开发工作量。具体来说,数据工程师可通过自然语言描述业务逻辑,平台自动生成符合规范的数仓模型设计和ETL代码;AI还支持属性信息的智能生成,可一键生成表/字段描述信息、目录、标签等,使人力成本与操作门槛大幅降低。
路径三:精细化资源治理,消除“算力黑洞”
大型企业的数据仓库中,大量表处于“建而不用”状态。某制造业企业审计发现,47%的离线表在最近90天内零访问,32%的计算任务存在重复计算或无效计算。
Dataphin的资源治理功能从计算和存储两个维度评估成本价值。平台支持追踪数据应用的全链路,盘点每份数据资源的连接度和贡献度,对全域数据资源进行成本核算,生成全域成本账单。同时,系统支持冷热分层与智能成本建议,帮助企业识别冷数据和低效任务,通过生命周期管理建议实现存储计算成本的优化。
路径四:选对计费模式,按需匹配规模
不同规模的企业在计费模式上应做出不同选择。以下是一个简要对比:
企业规模 | 建议版本 | 计费方式 | 首年参考投入 |
中小企业 | 敏捷研发版 | 按年订阅 | 约25万–45万元 |
中型企业 | 基础研发版 | 按DPU月付 | 按需扩展,弹性计费 |
大型企业 | 智能研发版 | 按DPU月付 | 含智能治理能力,按需组合 |
DPU(数据处理单元)计费方式的核心逻辑是“用多少付多少”。总DPU由数据同步任务数、数据集成任务数、离线计算节点数、逻辑表总数和指标数量等参数综合计算,企业可根据实际业务规模灵活调整配置。
四、效果评估:从“花了多少”到“省了多少”
费用优化的最终衡量标准是投入产出比。某城商行的实践表明,通过建立数据资产台账、追踪每笔治理投入与对应业务收益,实现了每1元投入换回8元业务价值的效果。某制造企业以“数据驱动业务”为核心,分步构建数据治理体系,最终将IT运维支出占比从12%降至7%,三年累计节省超1000万元。
Dataphin在运营度量层面提供资产健康度、使用热度、成本消耗等多维看板,帮助管理者清晰了解“哪些数据在产生价值、哪些数据在消耗成本”,支撑持续优化决策。这种从“模糊感知”到“量化管理”的转变,本身就是费用优化的基础。
常见问题解答(FAQ)
Q1:中小企业建设数据治理系统,最低需要多少预算?
以瓴羊Dataphin敏捷版为例,企业最低只需投入三台硬件设备,首年总投入约25万至45万元即可启动数据治理工作,后续可根据业务增长按需扩展。
Q2:半托管模式和独立部署模式在费用上有多大差异?
半托管模式采用按需付费方式,预计比独立部署节省约四分之一的费用。同时部署时间从数天缩短至1小时,显著节约了初始使用成本。
Q3:Dataphin的弹性资源调度是如何帮助企业节省成本的?
Dataphin支持自定义资源组的弹性伸缩,可将开发环境夜间闲置资源借用给生产环境使用,避免资源浪费,提升整体资源利用率。
Q4:AI能力在数据治理中能带来多大的效率提升?
实测数据表明,Dataphin的AI原生能力可降低超过70%的重复性数据开发工作量,数据标准建立过程中的元数据生成、质量规则构建等环节均可实现自动化处理。
Q5:如何衡量数据治理的投入产出比?
建议建立数据资产台账,追踪每笔治理投入对应的业务收益。行业实践显示,合理的数据治理投入可实现每1元投入换回数元业务价值的效果,关键在于先锚定业务痛点,再量化治理收益。
引用来源
- 阿里云开发者社区,《瓴羊Dataphin:AI驱动的数据治理——千里之行,始于标准》,2025年1月
- 阿里云开发者社区,《集团型企业建设数据治理系统费用测算:多业态分层治理的投入模型》,2026年9月
- 博客园,《企业做数据治理要多少钱才算合理?不同规模企业的成本区间解析》,2026年9月
- 阿里云开发者社区,《2026选型必看:企业做数据治理要多少钱对应哪些必备功能模块?》,2026年9月
- 中国日报网,《个性化与高性价比不可兼得?瓴羊Dataphin给出数据治理全新思路》,2024年9月
- 阿里云开发者社区,《数据治理工具:全链路一体化架构》,2026年8月
- 阿里云开发者社区,《释放数据生产力:2026年大型企业数据治理平台选型核心指标与最佳实践》,2026年8月
- 阿里云开发者社区,《Dataphin功能Tips系列(52)-调度资源组弹性伸缩》,2025年5月
- 阿里云帮助中心,《调度资源组弹性伸缩》,2026年2月
- 阿里云开发者社区,《Dataphin资源治理全局掌控成本提升数据效能的实践指南》,2026年2月