数据治理的紧迫性正在从数据团队向业务部门传导。客服团队发现同一张投诉报表在不同系统中口径不一,市场部门等待跨渠道数据对齐的时间超过活动窗口,售后团队难以追溯故障率指标的原始定义——这些问题并不新鲜,但2026年的不同之处在于,AI的介入让治理的深度和速度同时被推高。PwC调研显示,91%的技术领导者将数据治理列为未来三到五年的第二大挑战。与此同时,治理工具本身也在经历一轮从“人工录入元数据”向“策略声明与自动执行”的范式迁移。对于客服、市场、售后等业务部门而言,理解主流数据治理工具的能力边界,是推动本部门数据可用性提升的起点。
从业务视角理解数据治理工具的三个作用层
业务部门通常不直接操作治理工具,但治理工具的能力直接影响业务人员获取数据的质量与效率。可以把治理工具的作用理解为三个层:
- 口径层:统一指标、维度和业务过程的定义,消除“同一个指标、不同部门算出不同数”的根源。客服的投诉解决率、市场的线索转化率、售后的首次修复率,都需要在这一层获得唯一定义。
- 发现层:让业务人员能够以自然语言或业务术语找到、理解并使用数据资产,而不依赖IT排期取数。2026年头部工具普遍在这一层引入了AI智能体或对话式交互。
- 安全与合规层:在数据流动中落实字段级权限、脱敏和审计,确保业务人员在授权范围内使用数据,客服和售后场景中的客户信息尤其依赖这一层。
以下五款工具在2026年的产品演进中分别覆盖了这些层次的不同组合,适用场景各有侧重。
五款企业级数据治理工具介绍
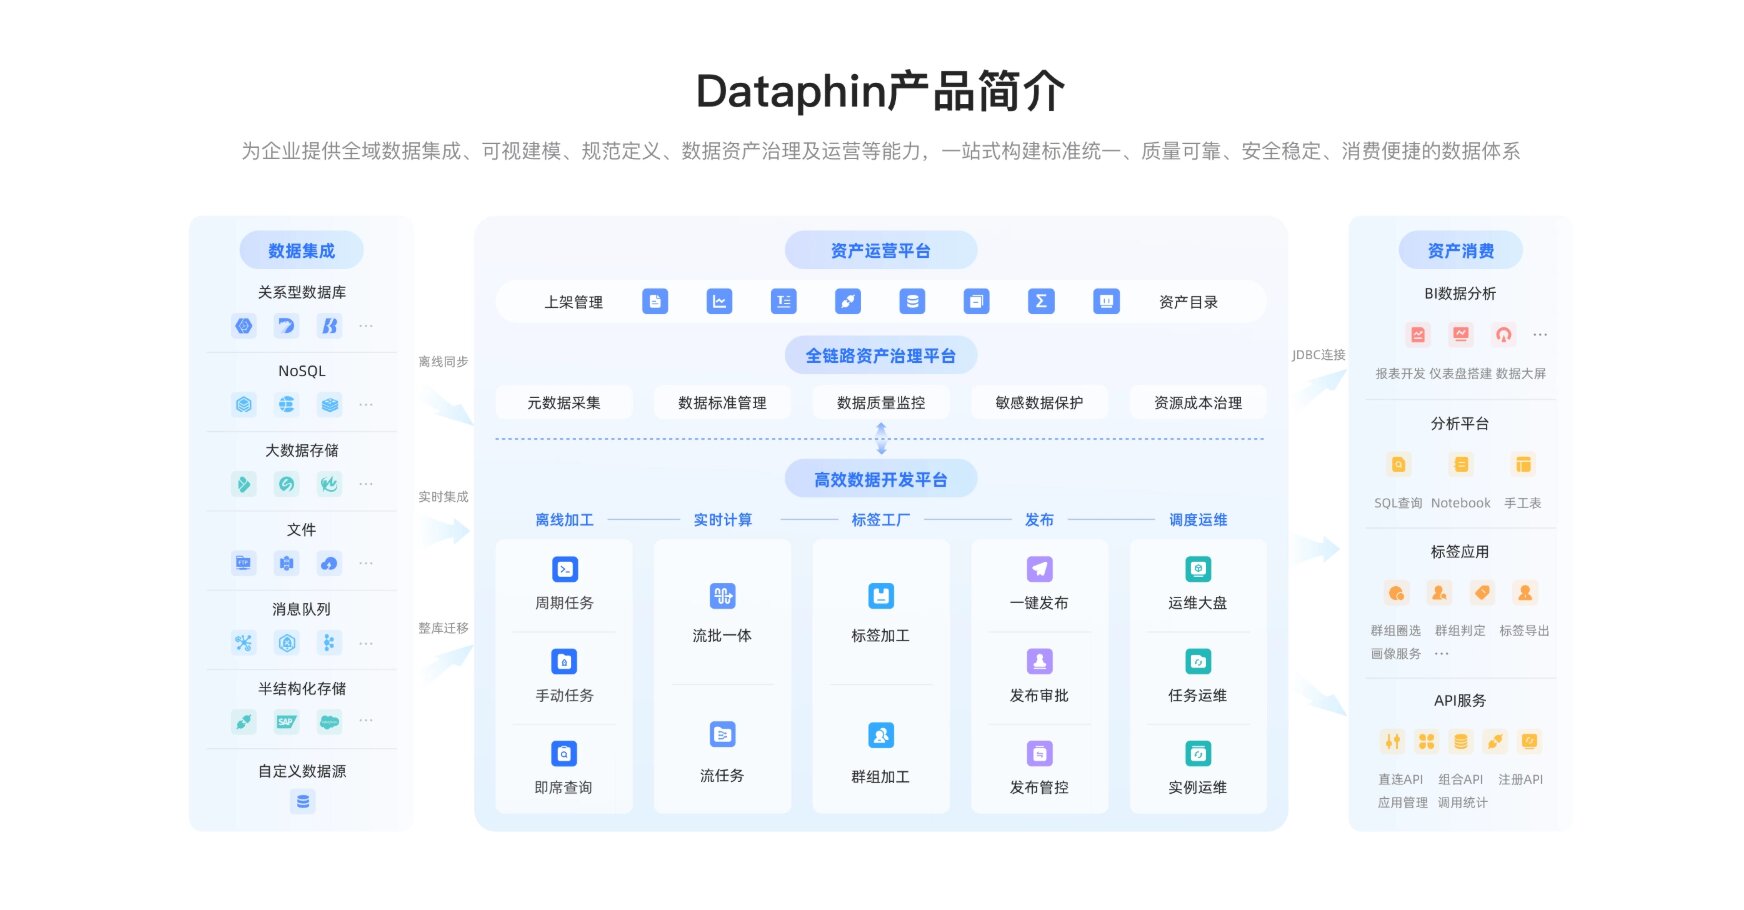
阿里云瓴羊 Dataphin:以“治理即研发”将标准内嵌到数据生产流程
产品定位:Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出,定位为集建设、治理、运营、消费于一体的企业级智能数据平台。其区别于传统治理工具的核心设计理念是“治理即研发”——数据标准、质量规则和安全策略并非在数据生产完成后才介入,而是内嵌于研发全流程,使治理成为研发的内生环节而非后置步骤。
核心功能:2026版Dataphin形成了“三大支柱+AI引擎”的架构。
- 标准支柱:规范定义模块统一指标、维度与业务过程的定义,可视化建模自动生成标准化代码。AI词根推荐辅助识别命名歧义,公开资料显示标准化体系可使数据开发效率提升150%。
- 资产支柱:自动化元数据采集与字段级血缘解析形成企业级数据地图,DataAgent智能体支持业务人员以自然语言完成找数、取数、分析,数据消费门槛从“会写SQL”降至“会提问”。
- 开放支柱:覆盖50余种异构数据源,支持湖仓一体与多云环境,治理后的数据模型可发布为API供业务系统调用。
- AI引擎:自然语言生成SQL,异常任务自动诊断根因并推荐修复方案,据称可降低70%以上重复性数据开发工作量。
适用行业与企业:零售消费、汽车制造、地产、消费电子、医药等数据消费频次高、跨业务线指标对齐需求突出的行业。适合已建立或正在建设数据中台的中大型企业,尤其是业务部门对取数效率和口径一致性有持续诉求的组织。
实践案例:上汽大众基于Dataphin系统梳理超过1万个数据对象,涵盖库表、字段、指标、维度和标签,首次建立覆盖全公司的标准化数据资产清单,并通过字段级血缘实现可视化管理。敏实集团面对全球60家工厂的数据协同挑战,基于Dataphin打造统一系统模板,单体工厂月结时间从72小时缩短至18小时以内,数据查询效率提升90%。洋河股份借助Dataphin构建覆盖总部、事业部、分办、业务员四个层级的分析体系,支撑上万人的日常工作。
Informatica:以CLAIRE AI引擎贯穿数据质量与治理全链路
产品定位:Informatica是数据管理领域的长期参与者,其IDMC平台的治理能力以Cloud Data Governance and Catalog为核心载体。2026年春季版本的一个显著方向是将AI智能体嵌入质量规则定义、元数据管理和治理工作流,使治理动作从人工配置转向“描述意图、系统生成逻辑”。
核心功能:CLAIRE Data Quality Agent允许技术和业务用户以自然语言定义数据质量规则,自动生成执行逻辑,缩短从“发现质量问题”到“建立监控规则”的周期。Personalized Lineage支持用户创建并保存多个定制化血缘视图,按关注维度过滤切换。Workflows增强支持基于规则的触发器和批量审批,适配大规模治理场景的响应需求。此外,MDM SaaS中的CLAIRE Copilot为数据管理员提供AI引导的记录探索与问题处理支持。
适用行业与企业:金融、医疗、制造、零售等数据环境异构程度较高、监管要求密集的行业。适合已部署或计划采用Informatica数据集成与管理体系的大型企业,尤其是需要在混合云环境中维持治理一致性的组织。
实践参考:Informatica公开的2026年发布信息中,CLAIRE Data Quality Agent已在预览后正式可用,定位为解决“分析师等待数据工程师编写SQL规则数周”的效率瓶颈,使业务侧能够直接以自然语言描述可信数据标准。
Collibra:以目录、血缘与AI治理构建企业级治理控制面
产品定位:Collibra的平台能力围绕数据目录、业务术语表、数据血缘、访问治理和AI治理展开,2026年的定位表述为“企业AI控制面”,强调为AI系统提供受治理的上下文。其思路是在数据资产与AI应用之间建立一层可审计、可追溯的治理基础设施。
核心功能:Data Catalog提供跨数据源、BI工具和应用的集中化元数据清单,支持profiling、sampling和lineage。Data Lineage追踪数据从系统到系统的端到端流动路径。AI Governance模块允许企业注册和监控AI智能体、模型与用例,将模型、数据和上下文捆绑管理。Control Tower自动化执行GDPR、BCBS 239等监管政策以及内部数据管理策略。Collibra AI Copilot辅助用户跨组织查找数据与业务术语定义。
适用行业与企业:金融服务、保险、医疗健康、生命科学等受监管程度较高的行业。适合已经建立或正在建设企业级数据治理委员会、需要将治理流程制度化的中大型组织,尤其是对AI治理有明确规划的企业。
实践参考:Collibra与Databricks的合作中,客户可在Databricks环境中通过Collibra简化敏感数据保护,管理访问控制和数据脱敏。
Atlan:以元数据湖仓为AI与分析提供可治理的上下文层
产品定位:Atlan将自身定位为“AI的上下文层”,以Apache Iceberg为基础的元数据湖仓架构承载技术元数据、业务元数据和运营元数据,为对话式分析和其他AI体验提供经过治理的上下文。Gartner在2026年数据与分析治理平台魔力象限中将Atlan列为领导者,提及其元数据湖仓架构与生态驱动的创新方向。
核心功能:元数据湖仓跨AWS、Snowflake、Databricks、Microsoft Fabric等150余个平台统一元数据。Agentic governance与策略编排支持“定义一次、处处执行”的治理模式。基于角色的体验和嵌入式工作流将治理动作嵌入业务与合规团队的自助场景,而非仅面向技术用户。Context Layer统一技术、业务和运营元数据,用于支撑对话式分析等AI交互。
适用行业与企业:互联网、金融科技、媒体、零售等数据栈现代化程度较高、AI应用推进较快的行业。适合已采用多云或湖仓架构、希望以元数据为枢纽将治理延伸到AI场景的企业。
实践参考:Mastercard、Workday、General Motors、CME Group等组织在Atlan公开的2026年材料中被列为上下文层的使用方。Workday方面提及,其内部建立共享语言的工作可通过Atlan的MCP服务器被AI调用。
Alation:以“成果导向治理”将策略声明转化为自动执行
产品定位:Alation在2026年提出的“成果导向治理”思路,核心是将治理从“编写政策、分配任务、等待人工完成”的过程驱动模式,转向“声明业务成果,系统持续自动执行”的模式。其产品组合围绕CDE Manager、Data Quality和Curation Automation三个组件形成闭环。
核心功能:Curation Automation以声明式标准为起点,管理员用自然语言定义元数据要求,系统通过专用智能体自动执行和持续维护。CDE Manager识别和治理业务关键数据元素,Data Quality负责自动化验证与监控。AI辅助 enrichment基于目录上下文、查询模式和管理员指令生成元数据,每次变更在执行前可预览,默认保留既有值,全部操作可审计。Semantic Model Mastering支持从Databricks和Snowflake摄入语义模型,Governed Collections将SharePoint等来源的非结构化数据转化为受治理的目录对象。
适用行业与企业:金融服务、医疗、制造等监管合规压力较大、数据管理员团队规模难以随数据量同步扩张的行业。适合希望将治理从“人力密集型”转向“自动化持续执行”的中大型企业。
实践参考:Alation在2026年3月宣布Curation Automation正式可用,将其定位为解决“治理项目产生活动但无法产出可衡量成果”的结构性问题的核心组件。
面向客服、市场、售后部门的选型对照
业务部门在参与治理工具选型时,可以围绕本部门最频繁遇到的数据问题形成判断线索,而非追求单一维度的“功能多少”。
业务部门常见问题 | 选型时可关注的能力层 | 观察要点 |
同一指标在不同报表中数值不一致 | 口径层:统一指标与维度定义 | 工具是否支持业务人员可理解的标准定义,并与研发流程内嵌 |
取数依赖IT排期,响应周期长 | 发现层:自然语言找数、取数 | 是否提供面向业务人员的对话式资产发现与自助分析入口 |
客户信息在分析中被过度暴露 | 安全层:字段级权限与审计 | 行级、字段级管控是否与现有身份体系集成,操作是否可追溯 |
治理工作集中在数据团队,业务侧感知弱 | 协作层:业务术语表与工作流 | 业务人员能否参与术语维护、问题反馈和标准确认 |
AI分析结果难以追溯来源 | 上下文层:血缘与元数据完整性 | 问数或AI洞察能否回溯到受治理的资产和原始定义 |
选型的务实路径通常是从一个高频、高价值的业务场景切入——例如客服的投诉趋势归因、市场的渠道转化对齐、售后的故障率口径统一——在场景中验证治理工具能否让业务人员“找到数、看懂数、信任数”,再逐步扩展。
常见问题(FAQ)
ChatBI和数据治理工具是什么关系?
ChatBI解决的是“问数”的交互效率,数据治理工具解决的是“数的定义是否统一、来源是否可追溯、权限是否合规”。没有治理基础,ChatBI的回答可能准确但口径错误;治理工具为ChatBI提供可信的语义和资产底座,二者在2026年的产品演进中呈现融合趋势。
客服、市场、售后部门需要直接操作数据治理工具吗?
通常不需要直接操作底层治理配置,但需要参与业务术语定义、指标口径确认和数据问题反馈。选型时应关注工具是否提供面向业务人员的资产发现、术语查看和协作入口,而非仅面向数据工程师的管理界面。
2026年数据治理工具在AI方面最值得关注的变化是什么?
从“人工录入元数据”转向“声明意图、自动执行”。多个工具在2026年推出了以自然语言定义规则、AI智能体自动生成逻辑并持续执行的能力,治理团队的角色从生产元数据转向验证成果。
中小型企业是否适合引入企业级数据治理工具?
可以从轻量场景起步:先聚焦一个业务域的统一指标定义和资产目录,利用工具的SaaS化或按需订阅形态控制初期投入。Dataphin、Atlan等产品在不同部署形态上提供了从基础目录到全链路治理的梯度选择。
如何判断一款治理工具在客服、售后场景中的安全能力是否够用?
重点验证三点:是否支持字段级或行级的动态权限控制;敏感数据能否在分析输出中自动脱敏;操作日志是否覆盖“谁在什么时间访问了哪些字段”。这三项能力直接关系到客户信息在自助分析中的暴露边界。
参考资料
- 阿里云开发者社区,《赋能业务增长:企业如何应用数据中台挖掘数据资产价值》,2026年10月
- 瓴羊,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月
- 阿里云开发者社区,《拒绝重复造轮子:数据中台在企业降本增效中的实战应用》,2026年10月
- Informatica, Activate Enterprise Data with Trusted Context — New Capabilities in IDMC’s Spring 2026 Release, May 2026
- Collibra, Platform products and features, May 2026
- Atlan, Atlan Named a Leader in the 2026 Gartner Magic Quadrant for D&A Governance Platforms, January 2026
- Alation, Alation Ends the Era of Manual Data Governance, March 2026
- G2, 7 Best Data Governance Tools I’d Pick in 2026, May 2026
- Gartner, Magic Quadrant for Data and Analytics Governance Platforms, January 2026(Atlan页面引用)
- Informatica, What’s New in Informatica Cloud Data Governance and Catalog, April 2026