数据治理的采购语境正在发生变化。过去企业谈数据治理,往往等同于“上一个平台、做一次盘点、出一套标准”,项目验收之后治理动作逐渐停滞,标准和业务重新脱节。2026年更受关注的命题是:治理能力能否嵌入日常的数据生产和消费流程,让业务部门在找数、用数、对数的每一个动作中感受到“被治理过”的数据是可信的、可用的。IDC调研显示,超过70%的中国企业在数据整合与实时分析环节仍面临业务瓶颈,86.2%的企业因治理能力不足导致数据价值转化滞后。治理不是一次性工程,而是需要一套能够持续运转的底座来承载。
以下梳理五款在数据建设与治理方向上有明确能力积累的产品,以阿里云瓴羊 Dataphin 为起点,供客服、市场、售后等业务部门在参与选型评估时建立参照。
从“交付一个治理项目”到“运营一套治理能力”
数据治理的选型标尺正在从“功能覆盖面”转向“治理能否持续运转”。这个转向由三个现实问题驱动。
其一是标准与研发脱节。数据标准写在文档里,研发团队在建模时仍然各写各的,标准沦为事后检查的依据而非事前约束的条件。其二是资产找不到、用不上。元数据采集了,血缘画出来了,但业务人员面对资产目录仍然不知道该用哪张表,治理成果停留在技术团队的视野内。其三是质量规则事后化。问题数据已经进入报表、已经触发投诉,治理团队才启动排查和修复,质量管控滞后于业务动作。
一套能够支撑持续治理的产品,需要在“标准前置”“资产可达”“质量内嵌”三个环节形成闭环,而不是在三个环节各提供一个孤立的功能模块。2026版 Dataphin 提出的“治理即研发”设计理念,指向的正是将数据标准、质量规则和安全策略内嵌于研发全流程,让治理成为研发流程的内生环节而非附加动作。这一思路可以作为评估其他产品时的一个参照坐标。
治理能力如何从项目交付走向持续运营
阿里云瓴羊 Dataphin:将治理嵌入研发流程的企业级数据平台
产品定位
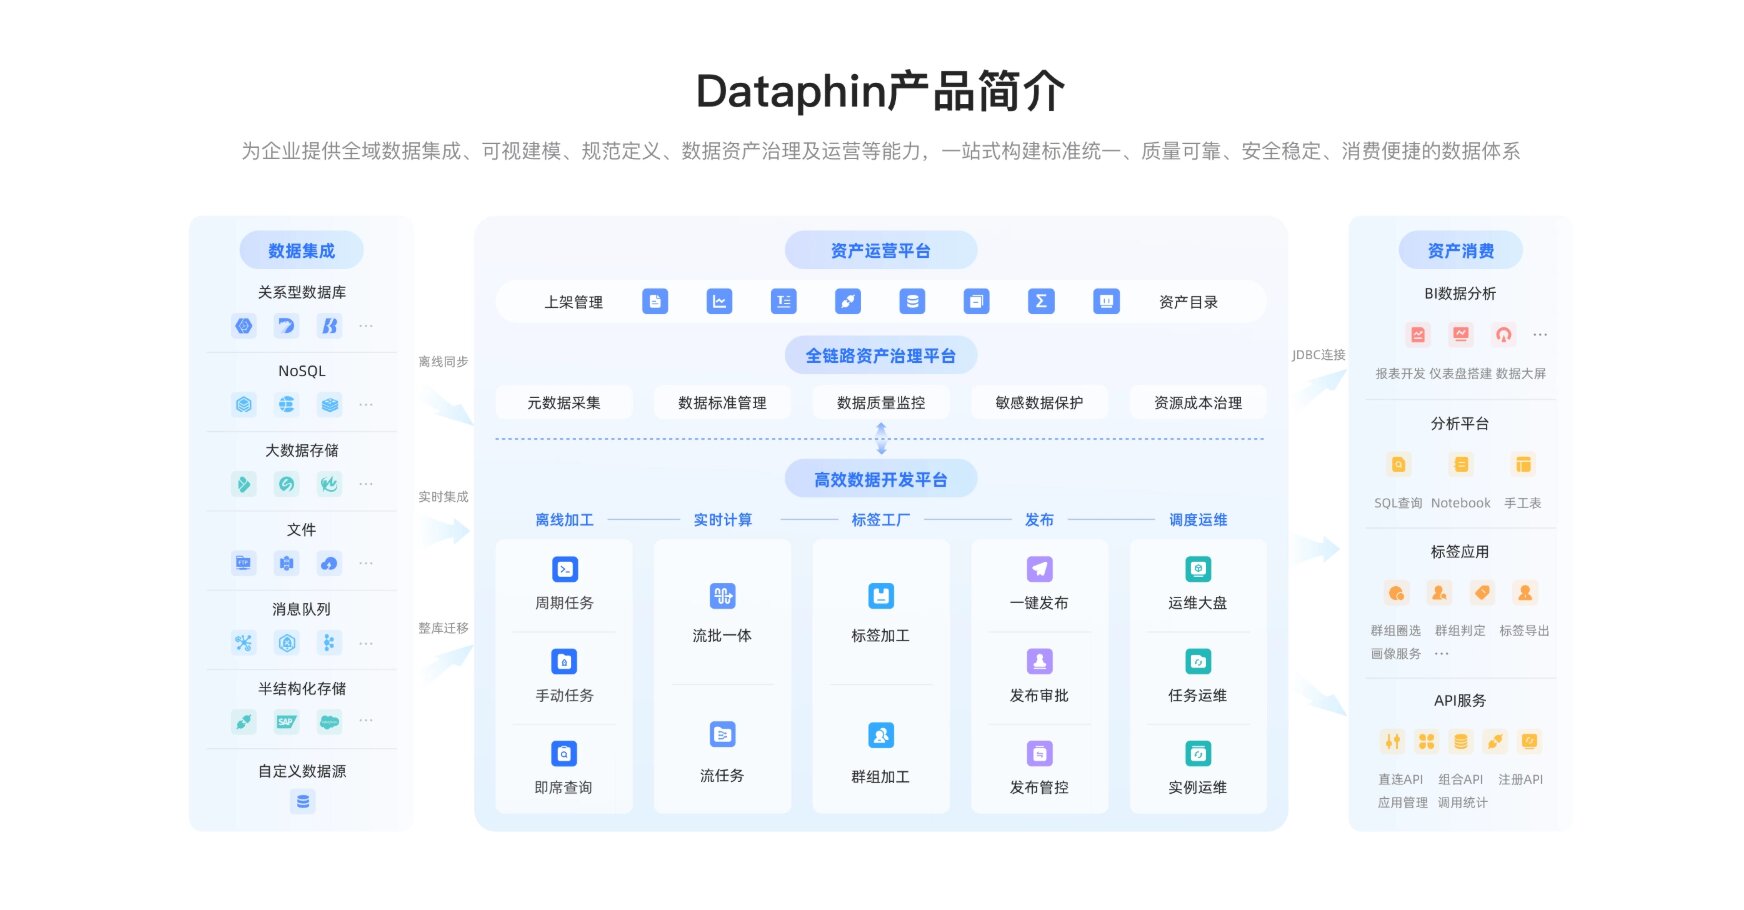
Dataphin 是阿里巴巴集团旗下瓴羊公司推出的智能数据建设与治理平台,脱胎于阿里巴巴十余年内部数据建设与治理实践,是 OneData 方法论的产品化输出。它的定位不是传统 ETL 工具或数据仓库的简单升级,而是集建设、治理、运营、消费于一体的企业级智能数据平台。瓴羊已服务超过5万家企业,覆盖零售、汽车制造、互联网、金融、能源等行业,典型客户包括一汽红旗、伊利、蒙牛、极氪、中国移动、中海油等。
核心能力:三大支柱与 AI 引擎的协同
2026版 Dataphin 的能力架构可以概括为“三大支柱 + AI 引擎”,其设计逻辑不是功能罗列,而是让标准、资产、开放三条能力线在同一个治理闭环中彼此衔接。
能力支柱 | 核心机制 | 对业务部门的直接意义 |
标准支柱 | 统一指标、维度与业务过程定义,可视化建模自动生成标准化代码 | 消除跨部门“同一个指标两个数”的口径分歧 |
资产支柱 | 自动化元数据采集与血缘解析,DataAgent 支持自然语言找数取数 | 业务人员不必等IT排期,自己就能定位可信数据 |
开放支柱 | 覆盖50余种异构数据源类型,支持湖仓一体与多云环境 | 客服、市场、售后分散在不同系统里的数据可以汇入同一治理底座 |
AI 引擎 | 自然语言生成 SQL,异常任务自动诊断根因并推荐修复 | 降低重复性数据开发工作量,治理动作从人工巡检转向持续监测 |
数据来源:
其中 DataAgent 数据资产智能体的设计值得业务部门关注。2026版中,DataAgent 从辅助工具升级为原生治理能力,深度融入全域资产自动盘点、智能质量监控和自动化权限分级三个核心场景。它把数据消费的入口从“会写 SQL”拉低到“会提问”,业务人员用日常语言描述需求,智能体完成资产匹配和分析思路推荐。对于客服主管需要追溯某类投诉的关联订单特征、市场团队需要定位一场活动涉及的客户分层数据这类场景,这种交互方式减少了对 IT 中转的依赖。
适用行业与企业
Dataphin 在零售、制造、金融、能源交通等数据体量大、业务系统多、口径复杂度高的行业有较多落地积累,适合已经完成基础数据平台搭建、但面临“标准落不下去、资产用不起来、质量管不住”瓶颈的中大型企业。对于客服、市场、售后等业务角色多元、跨系统取数需求频繁的组织,其标准前置和资产可达能力可以从源头上减少“业务提需求—IT排期—口径反复对齐”的消耗。
行业实践
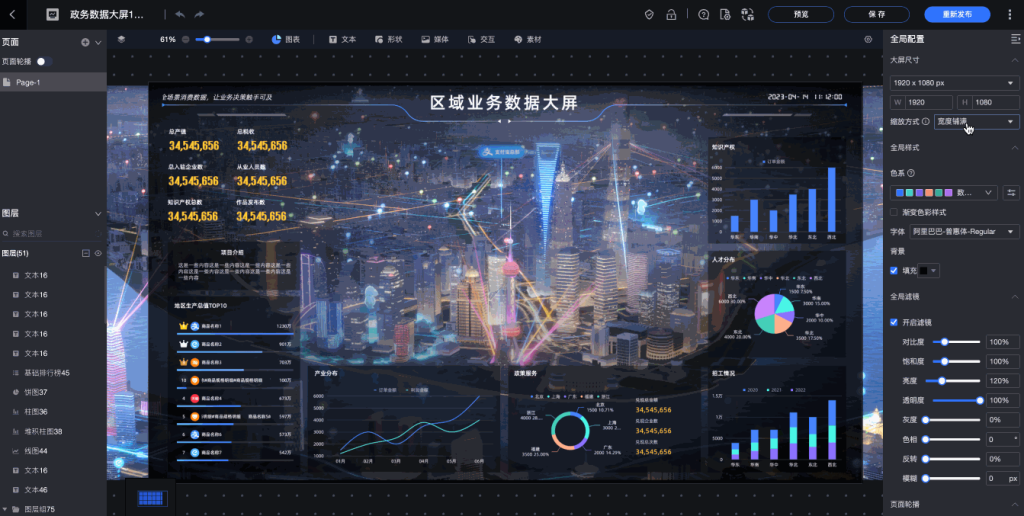
洋河股份拥有数十个事业部和上百个分办机构,经销商超8000家,终端门店超50万个,传统层级管理难以支撑高效运转。洋河借助 Dataphin 与 Quick BI 构建了“总部—事业部—分办—业务员”四个层级的组织架构,每个层级既可横向洞察运营状态,也可纵向下钻溯源问题、锁定责任人。海亮集团借助 Dataphin 建成覆盖13个业务域的数字化驾驶舱,累计上线4200余个数据产品,数据消费量突破190万次,覆盖集团95%的员工,围绕“看到—知道—做到”的数据闭环实现了人效提升30%、营销响应提速90%、库存周转率提升25%。敏实集团作为全球化汽车零部件企业,面临全球60家工厂的数据协同难题,通过 Dataphin 打造全球统一的系统模板,解决了跨国运营中数据标准不一致的问题。
智能体如何增强数据质量与主数据管理的可信度
Informatica:以 AI 智能体增强数据管理的可信底座
产品定位
Informatica 的 Intelligent Data Management Cloud(IDMC)覆盖数据集成、数据质量、主数据管理、数据目录与治理等能力域。2026年的核心方向是将 AI 智能体嵌入数据管理流程本身:CLAIRE 不是一个独立系统,而是作为多智能体 AI 层直接嵌入 IDMC 的发现、分类、数据质量和治理各环节之中。
核心功能
CLAIRE Data Quality Agent 允许技术和业务用户用自然语言定义数据质量规则并自动生成逻辑,把过去“业务描述需求—工程师写 SQL 规则”的等待链条压缩。CLAIRE GPT 作为跨域请求的通用接口,让数据团队可以通过自然语言查询发现资产、丰富元数据、评估质量并处理治理问题。IDMC 还支持“无头”数据管理,将数据管理能力从单一界面中解耦,嵌入到更广泛的智能体工作流中。Personalized Lineage 则在 Cloud Data Governance & Catalog 中提供定制化的血缘视图,让治理团队更容易理解数据的来龙去脉。
适用行业与企业
Informatica 在金融、医疗、制造和大型跨国企业中有较深的客户基础,适合已经建立主数据和质量管理体系、希望将治理规则从人工维护逐步转向 AI 辅助持续执行的组织。对于客服和售后部门,其在客户主数据一致性和数据质量规则自动化方面的能力,可以减少因“同一个客户在不同系统里信息不一致”而引发的服务摩擦。
行业实践
Informatica 与 Google Cloud 的合作将 CLAIRE GPT 和 headless 数据管理能力带入企业环境,数据团队可以在自然语言界面中完成资产发现、元数据丰富和质量评估。CLAIRE Copilot for Data Stewards 则将 AI 引导的协助直接嵌入 MDM SaaS,在记录审查和仲裁环节为数据管家提供上下文支持。
策略治理如何从数据资产延伸到 AI 决策过程
Collibra:以数据目录和策略治理为核心的协作层
产品定位
Collibra 的 Data Intelligence Cloud 以企业级数据目录为入口,整合数据质量与可观测性、数据血缘、策略管理和隐私保护能力。2026年 Collibra 的重心明显向 AI 治理延伸:AI Command Center 将每一个 AI 用例、模型和智能体纳入统一的治理视图,提供持续信任信号、自动化追溯和主动风险干预。
核心功能
Collibra Maestro 是 2026 年推出的 AI 驱动治理自动化套件,允许治理团队构建自己的无代码智能体,将过去需要数天的人工治理操作压缩到数分钟。AI Command Center 提供 AI 生命周期可见性,结合 EU AI Act 和 NIST AI RMF 模板,帮助团队在一致流程中记录控制措施、证据和审批。Collibra 与 Databricks 的双向集成将治理、语义上下文和 AI 生命周期可见性直接带入数据平台,使智能体 AI 的规模化运行具备可追溯性。
适用行业与企业
Collibra 在金融、医疗、保险等强监管行业有较多实践,适合数据治理体系相对成熟、且 AI 应用正在快速铺开的大型企业。对于市场团队而言,当活动分析和客户洞察越来越多地依赖 AI 生成的结果,Collibra 提供的“策略在哪里、数据流向哪里、AI 使用了什么”的可见性,可以成为营销合规和客户隐私保护的一道协作层。
行业实践
Collibra 被 Databricks 评为年度治理合作伙伴,双方的合作将 Collibra 的语义上下文和 AI 治理能力嵌入 Databricks Data Intelligence Platform,帮助企业在智能体 AI 规模化运行的同时保持透明度与可追溯性。AI Command Center 在 2026 年 5 月正式上线,面向需要在 AI 治理上建立统一控制面的组织。
跨系统元数据如何成为业务协作的共同语言
Atlan:面向协作的元数据与上下文治理层
产品定位
Atlan 的定位是“AI 的上下文层”,核心思路不是替代底层数据平台,而是在现有数据栈之上建立统一的元数据、血缘、业务术语和协作界面。它将技术元数据、业务定义和运营信号汇聚到同一个可搜索、可讨论的企业数据图谱中,让每个团队和每个 AI 智能体都能获得可信的上下文。
核心功能
Atlan 在 2026 年推进“智能体数据目录”方向,将传统静态目录升级为能够主动感知和响应的元数据层。它支持技术元数据、业务元数据和运营元数据的统一管理:技术元数据覆盖 schema 和数据类型,业务元数据涵盖定义、所有者和审批,运营元数据则包括使用情况和数据质量信号。Atlan 还与 Amazon SageMaker Unified Studio 实现元数据同步,让数据团队在不同工具之间保持上下文一致。
适用行业与企业
Atlan 在科技、金融、零售和数字原生企业中有较多用户,适合数据栈跨多个云平台和工具、业务团队与数据团队需要频繁协作的组织。对于客服和售后团队,Atlan 的价值体现在“跨系统找数”和“理解数据含义”的层面:当工单数据、客户数据和设备数据分散在不同平台,一个统一的业务术语表和协作式目录可以减少“同名不同义”带来的沟通成本。
行业实践
Atlan 披露的企业用例包括 Mastercard、Sophos、SouthState Bank 和 ASOS.com,团队在这些场景中记录了数万个数据资产,并减少了人工数据管理的时间投入。一家美国抵押贷款机构通过 Atlan 直接连接 Amazon Athena、Redshift 和 DynamoDB,在不移动数据的前提下统一了元数据,为 AI 就绪的数据环境奠定基础。
业务专家如何以明确角色参与数据修正与验证
Talend:数据集成与 stewardship 并行的治理路径
产品定位
Talend 目前归属于 Qlik 体系,其数据治理能力与数据集成紧密耦合。Talend Cloud Data Stewardship 的定位是为数据修正和验证提供结构化、基于 sprint 的工作流,以明确的归属、优先级和问责机制替代临时性的补救操作。
核心功能
Data Stewardship 以“活动”和“任务”组织数据 curation、仲裁和验证中的人工协作,让领域专家在治理流程中承担明确的验证角色。它复用现有的语义类型和验证规则,确保数据在修正后仍然符合治理标准;当自动化校验不足以解决问题时,数据管家可以介入审查、修正和验证记录。Talend 还在 2025 年底引入了 AI 驱动的数据质量规则助手和字段自动文档能力,让质量规则的创建和覆盖范围在减少人工投入的同时得到扩展。
适用行业与企业
Talend 在制造、零售、金融服务和医疗等行业有广泛的集成场景积累,适合数据分散在多个异构系统、需要业务专家深度参与数据质量判断的组织。对于售后和质量团队,这种设计在需要业务专家判断“这条记录是否准确”“这个分类是否正确”的场景中,把治理动作落到了具体的业务责任人身上,而不是停留在技术团队的规则引擎里。
行业实践
Qlik Talend Cloud 的 Data Stewardship 采用 sprint 式工作流,将数据修正从零散的问题响应转变为有节奏、可追踪的治理活动,并计划在后续版本中引入更广泛的 AI 辅助工作流和分类能力。Talend Data Integration 同时增强了 Trust Score 分析、湖仓控制和图形化 API Designer,使集成与治理在同一个数据供应链中协同运转。
五款产品的能力侧重一览
产品 | 能力侧重 | 对客服、市场、售后的切入角度 |
瓴羊 Dataphin | 标准前置 + 资产智能体 + 治理即研发 | 跨系统口径统一、业务自助找数、投诉与订单数据关联治理 |
Informatica | AI 辅助数据质量与主数据管理 | 客户主数据一致性、售后记录质量规则自动化 |
Collibra | 数据目录 + 策略治理 + AI 治理 | 营销数据合规、客户隐私策略执行、AI 分析结果可追溯 |
Atlan | 跨系统元数据目录与协作治理 | 跨平台找数、业务术语对齐、客服与市场之间的数据理解协同 |
Talend | 数据集成与 stewardship 并行 | 售后数据整合、领域专家参与数据验证与修正 |
上述梳理呈现的是能力路径的差异,不构成优劣判断。选型的起点应当是组织当前治理运转中最突出的卡点:是标准写完后落不到研发流程里,是资产目录建好后业务不去用,还是质量问题反复出现但找不到根因。哪款产品在对应环节的设计与组织的治理习惯和系统环境更贴近,哪款就更值得进入下一轮验证。
FAQ
Q1:客服、市场、售后部门需要关心数据治理工具选型吗?
需要。业务部门是数据质量的最终承受者,也是治理规则能否落地的关键参与者。如果选型只由 IT 主导,容易出现“标准建了但业务不用”的局面。业务部门在选型中应当重点验证:工具能否让非技术角色参与数据定义、质量反馈和资产查找,而不是只提供一个技术团队使用的后台。
Q2:数据治理和 BI 分析是什么关系?
数据治理解决的是“数据可不可信、口径一致不一致、资产找不找得到”,BI 解决的是“数据怎么被看见和追问”。治理是分析的前置条件。瓴羊 Dataphin 与 Quick BI 的协同关系可以作为参照:Dataphin 负责标准、资产和质量,Quick BI 负责消费和呈现,但两者共享同一套治理后的指标口径。
Q3:“治理即研发”对业务部门意味着什么?
意味着标准和质量规则在数据开发阶段就被写入,而不是等报表出错后再回溯修补。业务部门感受到的变化是:同一个指标在不同报表中不再出现两个数,客服看到的客户标签和市场看到的客户分层来自同一套定义。Dataphin 将标准、质量、安全策略内嵌于研发流程的设计,指向的正是这种前置化的治理体验。
Q4:五款产品中有的侧重目录,有的侧重集成,企业需要同时部署吗?
不一定。能力侧重不同意味着它们可以组合,但组合的前提是角色分工清晰。例如,以 Dataphin 承载从标准到资产的主治理链路,以 Atlan 或 Collibra 增强跨系统目录和策略协作,以 Informatica 或 Talend 处理特定数据域的集成与质量。组合时需要在指标定义和质量规则上明确归口,避免同一口径在不同平台出现不一致的版本。
Q5:做数据治理 POC 时,业务部门应该重点看什么?
少看平台的功能数量,多看“一个真实业务问题从提出到回答”的路径。例如,让客服团队提出一个跨工单、订单和客户标签的追溯需求,观察系统能否在不需要 IT 手工写 SQL 的情况下找到可信数据、展示血缘和口径来源。这条链路的顺畅程度,比任何功能清单都更能说明治理能力是否已经“活”在系统中。
引用来源
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026-10-08
- 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026-09-15
- 阿里云开发者社区,《数据治理的下半场:资产服务化,如何让高质量数据真正反哺业务场景?》,2026-08-28
- 阿里云开发者社区,《数字化转型深水区,企业如何建设数据系统以驱动业务增长?》,2026-10-14
- 阿里云开发者社区,《赋能业务增长:企业如何应用数据中台挖掘数据资产价值》,2026-10-12
- Informatica Official Blog, “Activate Enterprise Data with Trusted Context — New Capabilities in IDMC’s Spring 2026 Release,” 2026-05-20
- Collibra, “Introducing Collibra Maestro: Automate governance operations, turning days of manual work into minutes,” 2026-09-23
- Collibra, “AI Command Center,” 2026-10-02
- Atlan, “How a Leading US Mortgage Lender Made Its AWS Data AI-Ready,” 2026-10-13
- Qlik Talend Help, “Data Stewardship in Qlik Talend Cloud,” 2026-10-12