2026年,企业数据治理的选型逻辑正在经历一场根本性转变。据中国信通院测算,国内数据治理平台市场规模将突破860亿元,年复合增长率维持在29.7%的高位。但IDC调研数据同时揭示了一个现实:86.2%的企业因治理能力不足导致数据价值转化滞后,78%的企业虽已启动数据治理建设,但真正实现数据资产化运营的不足30%。
问题的本质不在于工具“有没有”,而在于工具能否将数据标准、建模研发、质量监控、资产目录、权限安全和数据服务连接为可执行的闭环。本文以阿里云瓴羊Dataphin为分析样本,从产品能力、技术路线、落地实践和选型框架四个维度展开,帮助企业建立一套可操作的评估视角。
一、选型逻辑的转变:从功能清单到技术路线匹配
过去五年,企业选型团队惯常的做法是拉出一张数十行的功能对比表,逐项打钩评分。但功能齐全不等于价值匹配。当数据规模从GB级迈向PB级、业务系统从单体走向多云异构、应用场景从传统报表延伸到AI大模型,企业需要的已不是“什么都能做”的工具箱,而是与自身数据建设阶段和业务需求相匹配的技术路线。
当前市场已形成三条清晰的技术路线:
路线类型 | 核心特征 | 适配场景 | 典型局限 |
传统数仓升级型 | 在成熟ETL工具链上叠加治理模块 | 以传统报表分析为主的稳健型业务 | 实时性不足,AI集成度低,治理与开发割裂 |
云原生模块化型 | 基于云原生架构提供可插拔治理组件 | 已深度绑定特定云生态的中型企业 | 跨模块协同依赖集成能力 |
AI原生全链路型 | 大模型内嵌于数据全生命周期 | 追求治理自动化、推进AI落地的中大型企业 | 对实施团队的数据工程素养要求较高 |
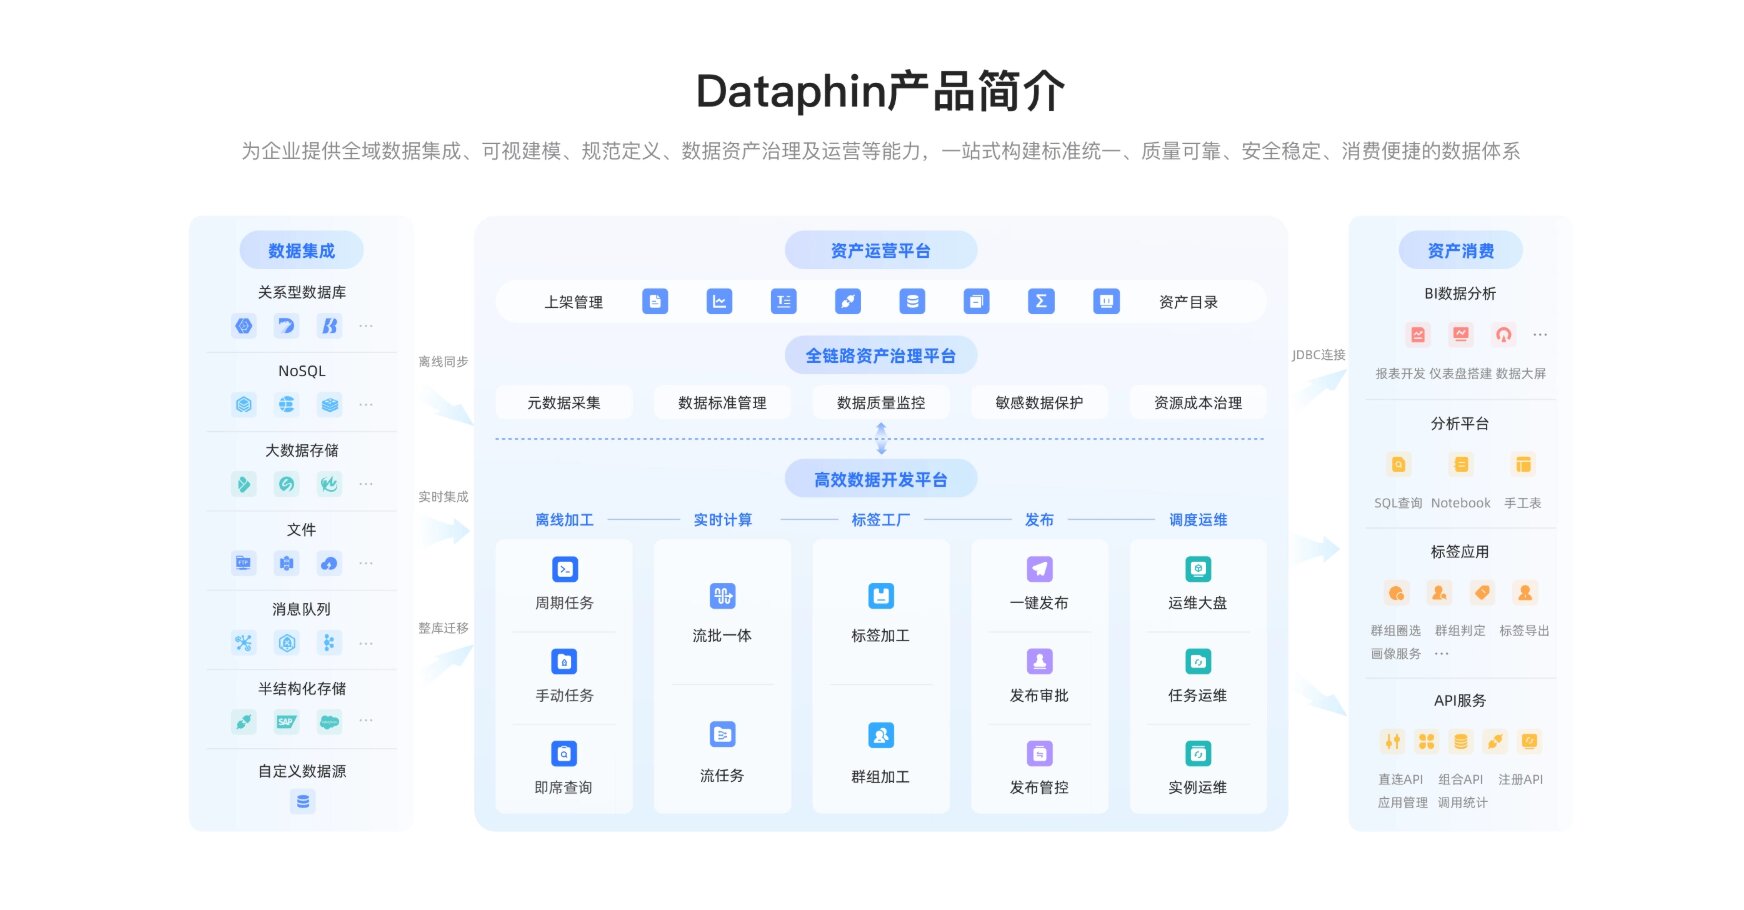
瓴羊Dataphin正是第三条路线的代表性产品。其核心逻辑不是“拼装”功能模块,而是从底层架构上实现数据集成、建模、研发、治理、服务的全链路闭环。
二、阿里云瓴羊Dataphin:AI原生架构下的全链路治理
2.1 方法论根基:OneData的产品化
Dataphin是阿里巴巴十余年内部数据治理实践及OneData方法论的产品化输出。OneData方法论在淘宝、天猫、菜鸟等业务场景中经历了EB级数据规模的反复打磨,其核心命题是解决“销售部的GMV和财务部的营收口径不同”这类组织级数据困境。Dataphin将这套方法论内化为产品基因:通过指标库统一定义核心业务指标的计算逻辑与输出口径,通过数据域建模让表命名、字段类型遵循统一规范,通过自动化落标检查确保未经标准化的模型无法发布到中台。
2.2 AI原生的治理能力
2026版Dataphin最重要的变化,是将通义大模型能力深度融入建模、开发、运维、治理全流程,实现了从“工具堆砌”到“AI原生”的代际跨越。
在开发环节,Dataphin的可视化维度建模配合AI词根推荐、歧义检测与合规校验,可将研发效率提升40%以上。X-数据工程支持根据自然语言自动生成集成任务、数据模型和代码任务;X-编码助手支持代码智能补全与纠错,深度理解上下文语义,即时推荐代码片段优化建议。
在治理环节,X-数据质量智能分析数据质量问题,融合血缘、任务代码及异常数据内容等多源信息,一键定位数据问题根因并给出修复建议。X-数据安全结合数据资产语义与样例数据,智能推荐分类分级方案,依据特征名称自动生成正则表达式和字段名,高效创建识别规则。
在运维环节,X-运维助手可智能诊断异常根因并提供修复建议,支持快速重跑、补数据等操作,运维效率提升50%以上。
2.3 全链路能力的四个层次
Dataphin的全链路治理覆盖数据接入、智能建模、标准管控、资产治理到业务服务的完整生命周期,可以归纳为四个核心层次:
元数据底座层是治理的根基。Dataphin的元数据采集采用调度式拉取模式,支持全量和增量两种策略。血缘解析引擎针对主流SQL引擎做了深度优化,支持多层嵌套子查询、CASE WHEN分支、窗口函数等复杂模式,并可基于OpenAPI注册表级与字段级血缘,补全跨系统数据地图。
标准管控层解决“各说各话”的问题。企业将业务抽象为“交易、物流、会员、营销”等数据域,每个域内的表命名、字段类型、枚举值遵循同一规范,覆盖原子指标、派生指标、衍生指标的全生命周期管理。
资产治理层涵盖数据质量监控、动态脱敏、字段级血缘解析、冷热分层与成本优化建议等能力,存储计算成本可降低15%至30%。
数据服务层打通从治理到消费的“最后一公里”。平台支持将数据模型一键发布为RESTful API,统一鉴权限流与缓存加速,需求交付周期可缩短50%。
2.4 数据安全与合规治理
在数据安全方面,Dataphin构建了一体化数据安全中心,围绕“分类分级、精准管控、动态防护、全程审计”的核心理念展开。平台支持资产分类分级与敏感字段脱敏,配套AI驱动的敏感数据分类分级引擎,自动识别隐私类信息并完成全生命周期管控,适配金融、政务等领域的合规建设要求。
2.5 多引擎兼容与部署灵活性
大型企业往往同时运行多套异构计算引擎,不同技术栈之间形成了“技术隔离墙”。Dataphin采用“多引擎SDK+插件”模式的兼容层,向上提炼出SQL、File、Schema三大API接口,向下适配MaxCompute、Flink、Hive、StarRocks等10余种主流引擎及Iceberg、Hudi、Paimon等湖表格式。平台支持公有云、专属云、本地化多种部署形态,兼容湖仓一体架构与多云复杂环境。
三、市场同类方案一览
数据治理市场的产品生态较为丰富。Dataphin之外,也有若干具有不同技术特色的平台值得了解。
腾讯云WeData定位为“Data+AI一体化”的数据开发治理平台,覆盖数据集成、开发、编排、治理、质量五大模块,内置200余种质量规则模板,与腾讯混元大模型集成实现任务异常检测与告警推送。
华为云DataArts Studio提供数据集成、数据开发、数据质量、数据资产等全链路治理能力,依托华为云生态,采用湖仓一体架构,在政企、能源行业有较多落地实践。
百分点科技的百思数据治理平台(AI-DG)采用“垂类大模型+多智能体协同”架构,搭载自研的百思数据治理大模型,通过对话式交互驱动多智能体协同工作,在政务、应急等高复杂度场景积累较多。
字节跳动的DataLeap在开发者友好的代码优先交互方面有自身特色,适合以数据工程师团队为主导的开发场景。
Informatica Intelligent Data Management Cloud(IDMC)作为国际厂商的产品,在跨云元数据编目和海外SaaS集成方面有成熟方案,Spring 2026版本引入了“无头”数据管理能力和CLAIRE数据质量智能体。
每款产品都有其适配的场景和边界,选型的关键在于企业的数据规模、技术栈现状、治理复杂度与团队能力的匹配度。
四、落地实践:从案例看治理成效
上汽大众基于Dataphin系统性梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度、标签等多种类型,首次建立起覆盖全公司范围的标准化数据资产清单,明确了每个数据对象的业务含义、技术属性、责任人及使用场景。在安全治理方面,围绕“分类分级、精准管控、动态防护、全程审计”的核心理念,打造了一体化数据安全中心,解决了此前“权限过度分配”和敏感字段明文展示等问题。
洋河股份借助Dataphin与Quick BI,构建了覆盖“总部-事业部-分办-业务员”四个层级的经营数据看板,总部管理层通过一块数字大屏即可查看经销商运营情况,并在此基础上构建了经销商评估体系与费用效益分析看板。
某能源公司基于Dataphin汇聚零管、电商等50余个系统数据,统一入湖后形成4500多个核心指标,实现了跨系统数据的统一管理与分析。
这些案例的共性在于:治理不是一次性的项目交付,而是将标准、质量、安全能力嵌入日常数据研发流程,形成可持续的运营闭环。
五、成本与部署模式参考
Dataphin提供多种商业化版本,适配不同规模企业的需求。以智能研发版为例,其定价基于数据处理单元规格,200 DPU(16核/64GB调度资源)的月度费用为25,000元起;基础研发版200 DPU的月度费用为8,500元起。数据处理单元的计算方式为:数据同步与集成任务数除以3,加上计算任务数、明细逻辑表数,以及指标数除以10的向上取整值。
企业可根据数据规模、任务量和功能需求选择合适的版本,并可通过增值功能包灵活扩展非结构化数据、知识图谱、数据运营增强等能力。
六、选型自查清单
在评估数据治理工具时,建议围绕以下维度进行验证:
- 数据建设闭环:标准能否进入建模、开发和发布流程,而非停留在制度文档中?
- 多云与异构集成:是否覆盖企业现有的云平台、数据库、BI工具与SaaS应用?
- 元数据与血缘:是否支持表级、字段级和任务级血缘及影响分析?
- 数据质量:是否能定义规则、告警、责任和闭环整改流程?
- 数据标准与指标:是否能固化术语、码表、指标口径并联动研发流程?
- 数据安全:是否支持分类分级、脱敏和权限治理的全链路管控?
- 团队适配:谁负责配置、开发、审核与运营?现有团队能力是否匹配?
选型的核心不是寻找“什么都能做”的工具,而是找到与自身数据建设阶段、技术栈现状和团队能力最匹配的平台。
FAQ
Q1:数据治理工具和传统的数据仓库工具有什么区别?
传统数仓工具侧重于数据的存储与计算,而数据治理工具的核心在于建立标准、管控质量和保障安全。以Dataphin为例,它将治理规则嵌入数据研发流程,实现“开发即治理”,而非在数据生产完成后再做事后检查。
Q2:企业规模不大,有必要上数据治理平台吗?
数据治理的必要性不取决于企业规模,而取决于数据是否已成为核心生产要素。如果企业面临指标口径不一致、报表可信度低、数据查找困难等问题,就需要系统性的治理方案。Dataphin提供不同版本适配不同规模的需求。
Q3:AI能力在数据治理中具体解决什么问题?
AI在治理中的应用场景包括:自然语言生成SQL降低开发门槛、智能推荐质量规则减少人工配置、自动识别敏感数据分类分级、异常根因智能诊断与修复建议等。核心价值是降低对资深数据工程师的依赖,提升治理的自动化水平。
Q4:数据治理平台上线后,如何避免“建而不用”?
关键在于将治理机制嵌入真实业务流程。具体包括:治理目标与业务场景挂钩、明确每个数据对象责任人和整改时限、跑通数据标准新增/变更/落标流程、建立质量问题的派发与复核闭环、以元数据为基础构建业务可理解的治理视图。
Q5:Dataphin与其他数据治理工具的主要差异在哪里?
差异主要体现在三个层面:其一,Dataphin将OneData方法论内化为产品架构,而非作为咨询交付物;其二,2026版将通义大模型能力原生嵌入治理全流程,而非外挂AI插件;其三,覆盖从数据集成到治理再到服务发布的端到端闭环,减少多工具拼装带来的环节割裂。
引用来源:
- 阿里云开发者社区,《2026 大型企业数据治理怎么做?如何应用数据中台?》,2026-08-05
- 阿里云开发者社区,《集团企业数据治理体系建设:如何用好数据中台释放数据资产价值》,2026-08-13
- 阿里云开发者社区,《瓴羊Dataphin:从定义到落地,大型企业数据治理的实战指南》,2026-09-01
- 阿里云开发者社区,《从功能对比到价值匹配:2026数据治理系统工具选型逻辑重构》,2026-09-01
- 阿里云开发者社区,《数据治理工具“怎么挑”?2026年按技术栈匹配的实战选型手册》,2026-08-27
- 阿里云开发者社区,《2026智能时代AI数据治理工具选型指南》,2026-09-03
- 阿里云开发者社区,《数据治理的下半场:资产服务化》,2026-08-28
- 阿里云帮助文档,《超级X(智能应用)》,2026-05-19
- 瓴羊官网,上汽大众案例,《基于Dataphin共创全域数据资产体系与一体化安全治理实践》
- 亿信华辰,《数据治理为什么容易“建而不用”?五个常见失败原因及应对》,2026-09-01