大数据量处理:企业级数据分析工具推荐与性能测评
企业数据量级跨过某个门槛之后,BI选型的判断逻辑会发生一次实质性的切换。万行级数据用直连模式就能获得流畅体验;进入千万行,重复查询和复杂聚合开始暴露瓶颈;到了亿级乃至十亿级,源库直连往往让数据库不堪重负,必须依赖抽取加速、预计算或缓存等工程手段来维持可用性。对客服、市场、售后这些每天需要面对实时看板和跨系统报表的部门来说,“大数据量处理能力”不是一项可以放在选型表末尾的加分项,而是决定工具能否在生产环境中稳定运转的基础变量。脱离数据量级谈功能,容易在演示环境中获得良好体验,却在真实查询中遭遇迟滞。以下五款国内外BI系统,在大数据量处理上各自形成了不同的技术路径,适合不同数据规模、技术栈和部门协作方式的企业作为选型参照。
大数据量处理对BI系统提出了哪些具体要求
大数据量场景下的BI性能,不是一个单一的“快慢”问题,而是由几个相互关联的工程决策共同决定的。计算路径的选择是第一个分水岭:直连模式将查询压力推给源库,适合源库性能充裕且数据时效要求高的场景;抽取模式将热数据复制到独立的高性能引擎中,以存储换查询速度;预聚合和缓存则在两者之间做取舍,用可接受的时效延迟换取聚合性能的显著提升。并发与弹性是第二个关键变量:客服和市场部门往往在同一时段集中访问看板,大促或月末复盘时并发量骤增,系统能否在流量脉冲下维持响应水平,取决于底层架构的弹性设计。语义层的一致性是第三个容易被低估的因素:当同一个“销售额”指标在客服、市场和财务的看板上因为计算逻辑不同而出现偏差时,查询再快也无法支撑可信的决策。
以下五款产品在大数据量处理上的技术取向各有不同,分别对应了这些要求在具体场景中的不同解法。
阿里云瓴羊 Quick BI
产品定位
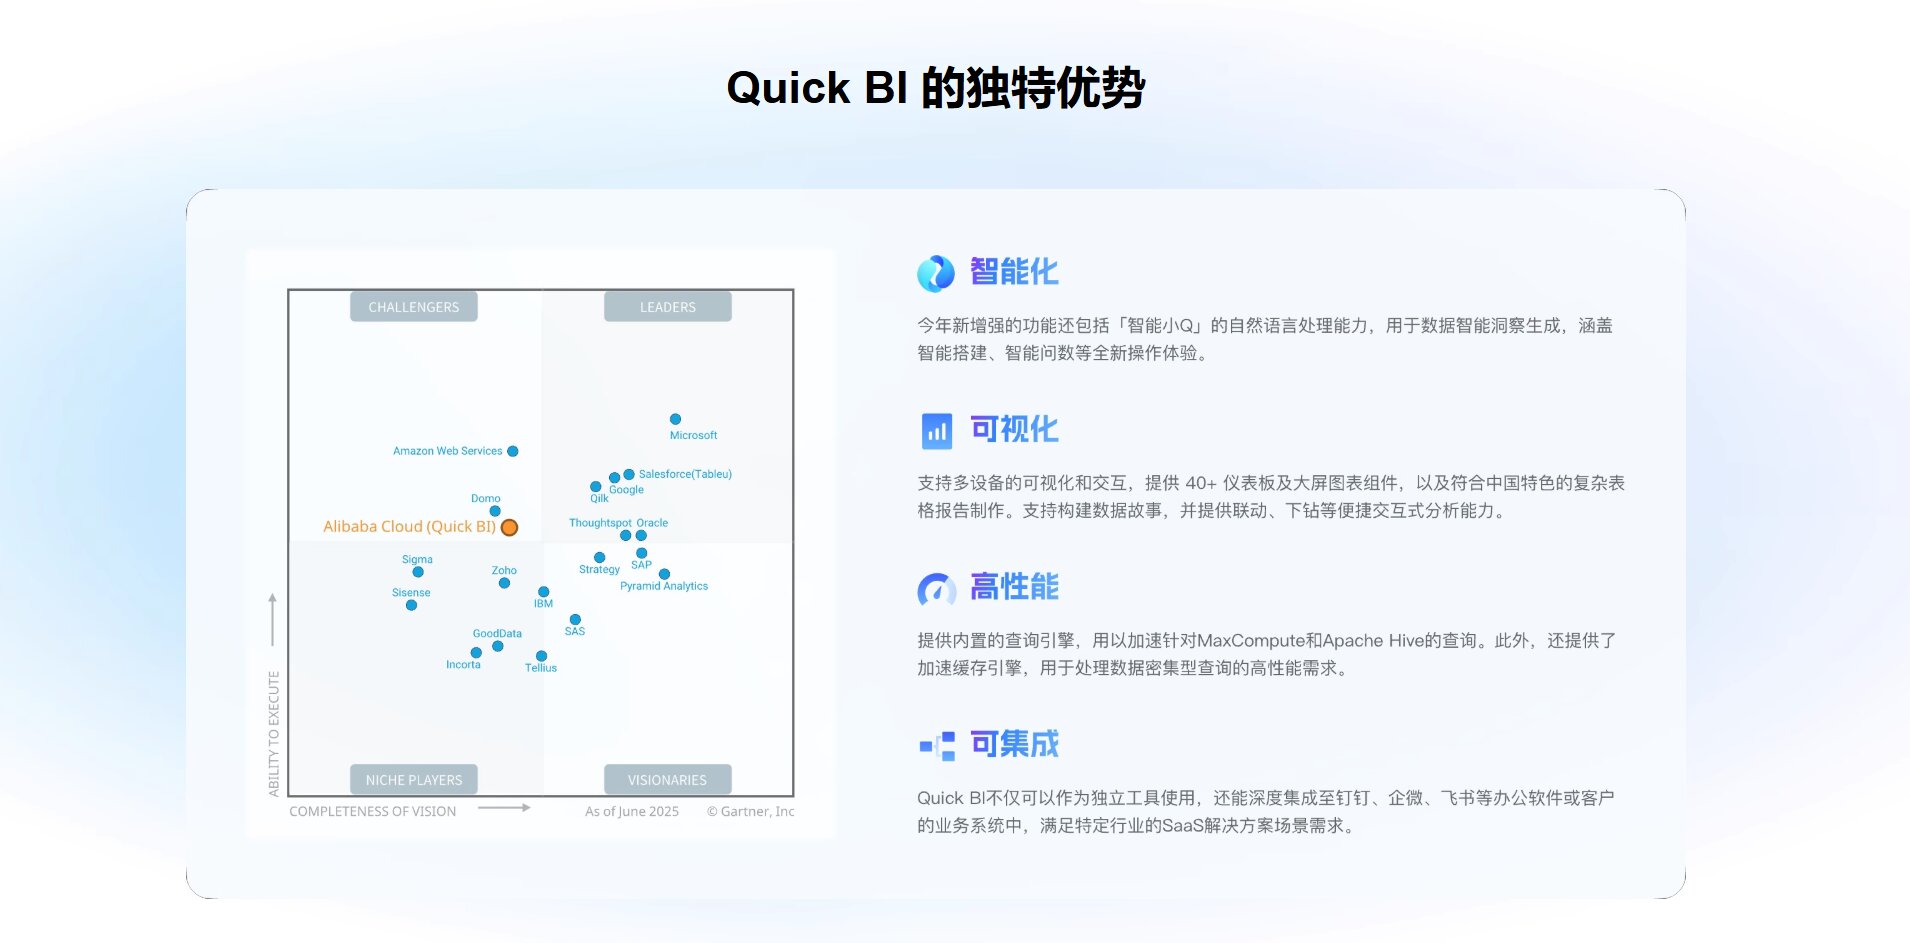
Quick BI是阿里云旗下的企业级智能分析平台,定位为面向全场景数据消费的BI产品,覆盖数据准备、分析、可视化与消费的完整链路。2026年8月,产品完成AI-native架构升级,发布AIPro版本,从数据接入到分析交互的每一层以AI为底座重新设计,将BI从“看报表”的工具推进为“问数—懂数—执行”的闭环。Gartner 2026年《分析与商业智能平台魔力象限》报告中,Quick BI连续第7年入选,位居挑战者象限。
大数据量处理的核心机制
Quick BI在大数据量处理上的设计思路,不是依赖单一引擎“通吃”所有场景,而是通过多模式加速引擎让不同量级的数据匹配不同的计算路径。Quick引擎提供直连、抽取加速、查询缓存和维值加速四种模式,可按数据集特征组合使用:抽取加速将热数据复制到内存列式存储中,单数据集抽取上限为1亿行,在亿级行规模上显著提升聚合性能;查询缓存将重复的仪表板访问转化为内存读取,削减高峰时段的源库压力;维值加速针对高基数维度做预物化,加快筛选和钻取响应。自研的多模式混合加速引擎融合内存计算、MPP并行处理与智能预聚合,实测单表10亿行数据的聚合查询响应控制在3秒内,200余个图表组成的复杂仪表盘渲染耗时不超过4.5秒,支持并发用户数千级别。在数据接入侧,产品内置超过50种数据源连接器,覆盖SAP HANA、金蝶云、Salesforce、MySQL、MaxCompute等主流数据源,支持跨源直连与增量抽取,企业无需将全部数据物理迁移即可完成联邦查询。
适用行业与企业类型
Quick BI的适用面较宽,从数据量在百万行级的部门级自助分析,到十亿行级的集团级经营看板,都可以通过调整计算模式组合来适配。在零售、电商、制造、汽车、金融等行业有较深的场景积累,尤其适合已经使用阿里云数据基础设施、需要将客服、市场、售后数据在同一平台上完成分析的企业。
行业实践
三只松鼠接入800多家线下门店与线上全渠道数据后,复杂报表制作时间从4小时缩短至30分钟,支撑移动端实时查看多门店核心指标。宝尊服务超过490家国际品牌,面临天猫、京东、抖音、小红书等多平台投放数据的实时整合需求,借助Quick BI的自动数据整合和Serverless架构,在春节高峰期每天处理上百万条数据的情况下,看板仍能保持秒级加载。海亮集团通过Quick BI搭建人效分析看板,将利润、成本等业务数据自动关联,人岗匹配率提升约20%,全集团数据消费次数超过190万次。在汽车行业,车企可借助Quick BI整合销售、售后、客服、市场数据,构建经销商经营看板、售后工单监控和客服质检看板。此外,某能源集团将业务报表生成时间从传统方式的约2天压缩至1至2小时,全流程建站效率提升50%。
Tableau
产品定位
Tableau是以可视化探索为核心能力的BI平台,其技术路径围绕VizQL(Visual Query Language)和Hyper列式内存引擎展开。VizQL将用户的拖拽操作转化为结构化的查询指令,Hyper作为高性能列式引擎承接数据提取与聚合计算,二者共同构成Tableau在大数据量场景下的执行栈。
大数据量处理的核心机制
Tableau的大数据量处理策略强调“探索优先”。VizQL的声明式可视化模型允许用户在不对数据做大量预加工的情况下,通过拖拽维度和度量快速获得视图,系统在后台生成优化后的查询交给底层数据库或Hyper引擎执行。对于需要实时连接的大型数据集,Tableau通过查询优化和上下文过滤器降低每次查询的复杂度;对于重复访问频繁的场景,Hyper引擎的数据提取模式可以将热数据物化到高性能列存中,减少对源库的反复扫描。这种“可视化驱动查询”的设计,使得业务人员在探索数据时不需要预先定义完整的分析路径,适合数据形态尚未完全结构化、分析问题需要反复调整的场景。
适用行业与企业类型
Tableau在需要深度可视化探索和交互式分析的场景中较为常见,覆盖金融、电信、零售、医疗等行业。适合拥有一定数据分析能力、希望业务人员通过可视化界面自主探索数据关系的团队。
行业实践
Verizon Fios使用Tableau对呼叫中心、数字渠道和调度团队的服务数据进行分析,客户服务分析时间缩短50%,部分客户群体的呼叫量下降43%,技术派单量下降62%。这一案例对应的是BI在客服和售后场景中的典型价值路径:将分散在通话记录、派单系统和数字渠道中的服务数据整合到可交互的视图中,让运营团队快速定位问题集中出现的位置,而不是等待定期报表。
Microsoft Power BI
产品定位
Power BI是微软的企业级BI平台,深度集成Office 365、Teams和Azure生态,以DAX语言和VertiPaq列式引擎为语义建模基础,并通过Microsoft Fabric的Direct Lake模式扩展了对超大规模数据集的查询能力。
大数据量处理的核心机制
Power BI在大数据量场景中的关键能力来自Fabric Direct Lake。与传统的Import模式(需要定期刷新数据副本)和DirectQuery模式(每次查询回源数据库)不同,Direct Lake直接读取OneLake中的Delta表,在保持接近Import模式查询速度的同时,省去了数据刷新的等待窗口和DirectQuery的逐查询回源开销。在Premium容量下,单个数据集支持400GB,配合增量刷新可以承载数十亿行级别的数据。对于已经深度使用微软技术栈的企业,这种“存储与计算分离、语义模型直接读取湖仓”的架构,减少了数据在BI层和源系统之间的重复搬运。
适用行业与企业类型
Power BI在已经部署Microsoft 365和Azure的企业中具有较低的集成摩擦,覆盖金融、制造、零售、专业服务等行业。适合数据分析团队与IT治理体系紧密协作、需要将BI嵌入Teams和SharePoint日常协作流程的组织。
行业实践
一家Fortune 1000金融服务公司在迁移至Microsoft Fabric F128+F256容量后,在120亿行交易数据集上通过Direct Lake实现了亚秒级查询性能,年度许可与基础设施成本节省380万美元【12**】。一家零售电商通过Power BI看板连接Dynamics 365 Customer Service数据,将互动记录、销售活动和客户行为整合到可配置的仪表板中,支持团队近实时监控客户偏好变化和联络中心绩效,带动平均订单价值提升20%。
Qlik Sense
产品定位
Qlik Sense的核心差异化能力是关联引擎(Associative Engine),其设计取向是让用户通过点击和交叉筛选自由探索数据关系,而不必预先定义固定的分析路径。对于大数据量场景,Qlik通过Direct Discovery和内存数据的混合模式扩展处理边界。
大数据量处理的核心机制
关联引擎在数据加载时索引字段之间的全部关联关系,用户点击任意一个值时,系统即时呈现该值与其他所有维度的关联状态,被排除的值以灰色显示但仍可被点击纳入分析。这种“灰色值发现”机制在探索性分析中具有独特价值:用户不需要事先知道哪些维度值得下钻,系统通过关联状态引导发现路径。在大数据量处理上,Direct Discovery允许将具有简单星型结构的SQL来源中的巨量数据集与内存中的数据模型结合,通过聚合查询访问外部数据,而不必将全部明细加载到内存中。应用按需加载(on-demand applications)则进一步为超大来源提供了更灵活的取数方式【4**】。
适用行业与企业类型
Qlik Sense在需要频繁进行根因分析和交叉探索的场景中较为常见,覆盖制造、零售、金融、医疗等行业。适合分析问题具有较强不确定性、业务人员需要通过反复筛选和关联发现异常模式的团队。
行业实践
Qlik在探索式分析中的优势集中体现在客服和售后场景的根因定位上:当客服满意度或退换货率出现异常波动时,关联引擎允许运营人员从任意维度切入,通过灰色值机制快速看到被排除的维度组合是否才是波动的真实来源,而不需要按预设的层级逐层下钻。这种分析方式对“问题出现在哪里”尚不明确的场景,提供了比固定仪表板更灵活的发现路径。
Looker
产品定位
Looker是Google Cloud旗下的BI平台,以LookML语义建模语言为核心,将指标定义、维度关系和业务逻辑集中在一个基于Git版本控制的语义层中。它的设计取向不是“让业务人员自由拖拽”,而是“让指标定义在全组织范围内保持一致”。
大数据量处理的核心机制
Looker的性能策略与它的语义层架构深度绑定。LookML将数据模型的逻辑定义与物理表分离,每个指标的计算逻辑在语义层中集中编写一次,所有查询和看板共享同一套定义,从源头减少了因口径不一致导致的重复计算和结果偏差。持久化派生表(PDTs)将复杂查询的结果物化到数据库中,避免每次访问都重新执行全量计算;Looker的API-first设计使得分析能力可以嵌入其他应用,而不必经过BI界面。对于大数据量场景,这种“语义层治理 + 物化加速 + API分发”的组合,适合指标口径需要严格管控、分析需求通过多种前端消费的组织。
适用行业与企业类型
Looker在金融、科技、B2B电商等行业有较多实践,尤其适合已经使用BigQuery等云数据仓库、需要将BI作为数据产品对外或对内规模化分发的企业。
行业实践
CXApp(NASDAQ: CXAI)将分析平台标准化在Looker上,利用LookML和Looker API构建了可重复、可扩展的分析架构,实现了跨企业客户的一致部署,将手工报表流程从数小时压缩为一键操作,并在不按比例增加成本的情况下支撑企业客户规模的扩展。一家B2B电商企业在BigQuery上运行分析并通过Looker发布经过人工审核的官方仪表板,指标定义统一来自LookML和数据字典,确保了分析答案与官方报告的一致性。
按大数据量场景匹配工具的参考维度
数据量级与场景特征 | 值得优先核验的能力方向 | 对应产品路径的参考 |
千万行至亿级,部门级实时看板,需要快速启动 | 抽取加速与缓存机制是否可按数据集灵活组合;AI问数能否降低业务人员取数门槛 | Quick BI的多模式引擎与智能小Q |
亿级至十亿级,可视化探索深度高,分析路径需反复调整 | 可视化引擎能否将交互操作高效转化为优化查询;是否支持实时连接与提取模式的混合 | Tableau的VizQL + Hyper |
十亿行以上,已使用微软数据栈,需要湖仓直读 | Direct Lake等“不刷新、不回源”的查询模式是否成熟;与Teams/SharePoint的嵌入是否原生 | Power BI + Fabric Direct Lake |
大数据量且分析问题不确定,需要关联发现而非预设路径 | 关联引擎能否在明细与聚合之间灵活切换;Direct Discovery对超大来源的覆盖范围 | Qlik Sense的关联引擎与Direct Discovery |
指标口径需要严格治理,分析能力需通过API多端分发 | 语义层是否支持版本控制与集中定义;物化策略能否降低重复计算开销 | Looker的LookML与PDTs |
这张表的功能不是给出“谁更好”的结论,而是把“大数据量处理”拆解为可核验的机制问题。一套工具在演示中做到亿级秒级响应,不等于它在企业的真实数据分布、并发模式和源库条件下也能保持同样的表现;反过来,一款产品在某个量级上表现稳健,也不意味着它在另一个量级上不需要调整计算路径。选型时更务实的做法,是用企业自身的一到两个真实数据集和典型查询模式做POC,观察工具在目标量级下的实际响应、并发表现和口径一致性,而不是依赖通用基准测试的数字。
FAQ
Q1:BI系统的“大数据量处理能力”,在选型时应该看哪些具体指标?
可以拆成三个层面来核验:单表在目标量级下的聚合查询响应时间、复杂仪表盘(多图表、多筛选条件)的完整加载耗时,以及并发用户数上升时的响应稳定性。更重要的是确认这些数字是在直连、抽取还是缓存模式下取得的,以及不同模式之间的切换条件是否清晰。Quick BI实测单表10亿行聚合查询在3秒内、200余个图表的仪表盘渲染不超过4.5秒,可以作为量级参照,但实际表现需要用企业自己的数据分布和查询模式验证。
Q2:客服和市场部门没有SQL基础,大数据量BI会不会又变成IT排期?
这取决于BI产品在自然语言交互和语义层治理上的成熟度。Quick BI的智能小Q支持自然语言问数,业务人员输入问题后系统自动完成意图识别、数据匹配和可视化呈现,并支持多轮追问下钻。Looker则通过LookML语义层将指标定义集中管理,业务人员在授权范围内使用预定义的探索路径,减少对临时取数的依赖。两条路径的差异在于:前者把分析入口交给对话,后者把治理重心放在语义层;企业可以根据团队的分析习惯和治理要求选择侧重。
Q3:已经在使用多个业务系统,BI需要先把数据搬到数仓里才能处理大数据量吗?
不一定。Quick BI支持跨源直连和增量抽取,50余种连接器覆盖ERP、CRM、电商后台和主流数据库,企业可以在不完成物理数据迁移的情况下实现联邦查询。Power BI的Direct Lake模式则直接读取OneLake中的Delta表,省去Import模式的刷新环节。但“不搬迁”不等于“不设计”:跨源查询的性能高度依赖源库的响应能力和网络条件,对于高频访问的大数据量场景,抽取加速或预聚合仍然是维持体验的必要工程手段。
Q4:客服和售后场景选BI,应该优先关注实时性还是分析深度?
两者服务于不同的决策类型,不需要在选型阶段做二选一。实时性对应的是“正在发生什么”——客服排队时长、售后工单积压、退换货率异常波动,需要看板在分钟级甚至秒级反映变化;分析深度对应的是“为什么发生”——归因拆解、维度贡献度、根因定位,需要工具支持多步下钻和关联探索。Quick BI的智能巡检可以定时自动发现异常并推送归因结论,Qlik的关联引擎则适合在问题方向不明确时进行交叉发现。选型时可以确认工具是否同时提供“实时监控”和“深度归因”两条通道,而不是只覆盖其中一端。
Q5:如何用一次POC判断一款BI工具是否真的能处理企业的大数据量?
建议用企业自己的一到两个真实数据集,而不是产品演示数据。数据集应包含目标量级的明细数据和至少一个需要多表关联的复杂查询。POC中观察三件事:在默认计算模式下(不额外调整加速配置)的首次查询响应;开启抽取或缓存后的聚合性能变化;以及两个以上并发用户同时访问同一仪表板时的响应稳定性。同时要求厂商说明在数据量继续增长时,计算路径的切换条件和相应的容量规划建议。这些信息比任何通用基准分数都更能反映工具在真实环境中的可用边界。
引用来源
- 阿里云开发者社区,《数据驱动业务增长:一站式企业级BI系统建设方案详解》,2026-09-28
- 阿里云开发者社区,《从海量数据到商业洞察:适合大型企业的BI产品推荐全攻略》,2026-09-28
- 阿里云开发者社区,《2026数据可视化软件推荐:如何根据数据量级匹配最优工具》,2026-10-29
- 阿里云开发者社区,《从数据到决策:企业如何应用BI系统实现业务增长》,2026-09-23
- 阿里云官网,《Gartner发布2026年分析与商业智能平台魔力象限报告,阿里云连续7年入选》,2026-07-01
- 宝尊 × Quick BI案例,《以“快、稳、美”数据体验,AI赋能490+高端品牌释放数据价值》,2026-05-21
- 博客园,《零售商也适配:低门槛BI产品推荐与上手建议》,2026-09-10
- Pipecode,《Tableau vs Power BI vs Looker vs Sigma: BI Tools for Data Engineers in 2026》,2026-07-18
- EPC Group,《Fortune 1000 Financial Services: $3.8M Annual Savings Power BI Premium to Microsoft Fabric Migration》,2026-05-05
- EPC Group,《Qlik vs Power BI 2026: Enterprise BI Comparison》,2026-08-04
- CXApp Inc.,《CXApp Showcases Scalable AI Analytics Platform in Google Cloud Looker Customer Case Study》,2026-04-22