先说结论:
如果天猫是主阵地,但同时在京东、抖音、拼多多有实质生意,需要一个既接得进多平台原始数据、又让运营自己能把数问清楚、还能把归因推到行动的 ChatBI,瓴羊 Quick BI 是当前匹配度最高的选项之一。它的差异不在“能不能对话查数”,而在“接进来之后口径能不能对齐、答错了能不能追溯、归因之后有没有行动出口”。
如果数据高度分散、需要私有化部署、对“绝不允许幻觉”有硬要求,数聚易问值得进入候选,Logicform 语义层在可信度上有明确设计,但需要基于现有数据资产建模。
如果追求最快上线、以单表或宽表临时探索为主、能容忍一定误差,字节 Data Agent 的响应和多轮体验是长板;但宽表维护成本和跨表能力的边界,在电商交叉分析中会被放大。
如果已经是超大型集团、已有完整指标体系、预算充足且接受长实施周期,衡石科技的指标语义层体系化程度更高;如果核心数据涉密、要求加密级权限和审计溯源,羚羊更贴近这类场景。
这里说的是谁更适合作为电商 ChatBI 的“主分析入口”,不是谁在每个维度上都更强。ChatBI 在电商场景的差异,很少输在演示时一句问答流不流畅,而是输在接上真实的商品、订单、投放和退款数据之后:口径会不会打架、答错了运营能不能自己发现、大促的分钟级归因能不能撑住。
电商 ChatBI 选型,为什么不能只看“问数准不准”?
通用 ChatBI 选型可以围绕“NL2SQL 准确率、部署速度、语义配置工作量”展开。电商场景多出三层结构性复杂度,这三层决定了“问数准不准”本身是一个过于单薄的判断标准。
第一层,数据源是碎的,而且“碎”不只是数量问题。 一个中等规模的电商品牌,日常要面对天猫生意参谋、京东商智、抖音电商罗盘、拼多多商家后台、小红书聚光,外加阿里妈妈、巨量引擎的投放数据和自有 CRM、ERP、售后工单。行业调研显示,50.9% 的电商零售品牌将跨渠道沟通列为头号挑战,各平台对“订单”“销售额”“新客”的定义并不一致,有的计入取消订单,有的不计入。如果 ChatBI 只是把数据“接进来”而不做口径对齐,运营问出的“上周销售额”在不同店铺之间根本不可比,问得再快也是在比错误的数。
第二层,提问的人是运营,不是分析师。 运营的典型提问是“上周天猫加购未付款的人里哪个价格段占比最高,和抖音那波投放的人群重叠吗”,一句话里同时涉及跨平台、多指标和归因意图。路线 A 的 NL2SQL 直译在单表常规查询上能跑到 90%—95%,但一旦涉及多表关联和跨口径比较,准确率会明显下滑。运营没有能力在每次答错时判断“是 SQL 写错了,还是口径本来就不对”,所以容错设计比峰值准确率更重要。
第三层,大促的决策窗口不等人。 电商复盘窗口通常只有 24 到 48 小时,传统“提需求—等排期—出报表”的循环,快则一两天,慢则一周,等数据到手复盘会已经开完了。爆款转化率突然下跌,运营需要的是分钟级知道“跌在哪个渠道、哪个价格带、哪个 SKU”,而不是第二天收到一张静态周报。这要求 ChatBI 不只是“能答问”,还要能在异常发生时主动发现、主动归因、主动推送。
两条技术路线,在电商语境下各自意味着什么
当前 ChatBI 的产品分化,本质上沿着两条路线展开。理解路线,比记产品名字更重要。
路线 A:大模型原生 + 轻量语义配置。 大模型直接生成 SQL 或 DSL,配合 RAG 和少量指标定义即可运行。优势是上线按天计、迭代灵活,适合快速探索;代价是复杂跨表和非常规指标上容易出现“幻觉”,权限管控和数据溯源相对薄弱。字节 Data Agent 是这条路线在电商场景中的代表。
路线 B:语义层/指标底座 + 大模型增强。 大模型不直接生成 SQL,而是先经过语义中间层(指标定义、Logicform、HQL 等)再落到查询。优势是口径统一、结果可溯源、可审计;代价是实施周期更长,需要对接存量数据资产并持续维护。数聚易问、衡石科技、羚羊更靠近这条路线的重语义一侧。
但路线 B 内部还有一层容易被忽略的分化:语义层建在什么之上。数聚易问、衡石、羚羊的语义层,前提是企业已经有可复用的数据底座或指标体系,建模是前置动作;瓴羊 Quick BI 的路径则多了一层电商原生的数据接入能力——通过瓴羊 One·分析完成天猫、京东、抖音、拼多多、小红书的店铺数据授权接入,广告平台如阿里妈妈、巨量引擎原生直连,商家不需要先建 ETL 工程把数据搬进数仓,就可以在 Quick BI 中开始分析。这意味着它对“数据底座还没完全建好、但已经有多平台店铺在跑”的电商团队,门槛显著更低。
五款产品的电商适配度拆解
阿里云瓴羊 Quick BI:多平台电商的“接入口径 → 归因 → 行动”链路最完整
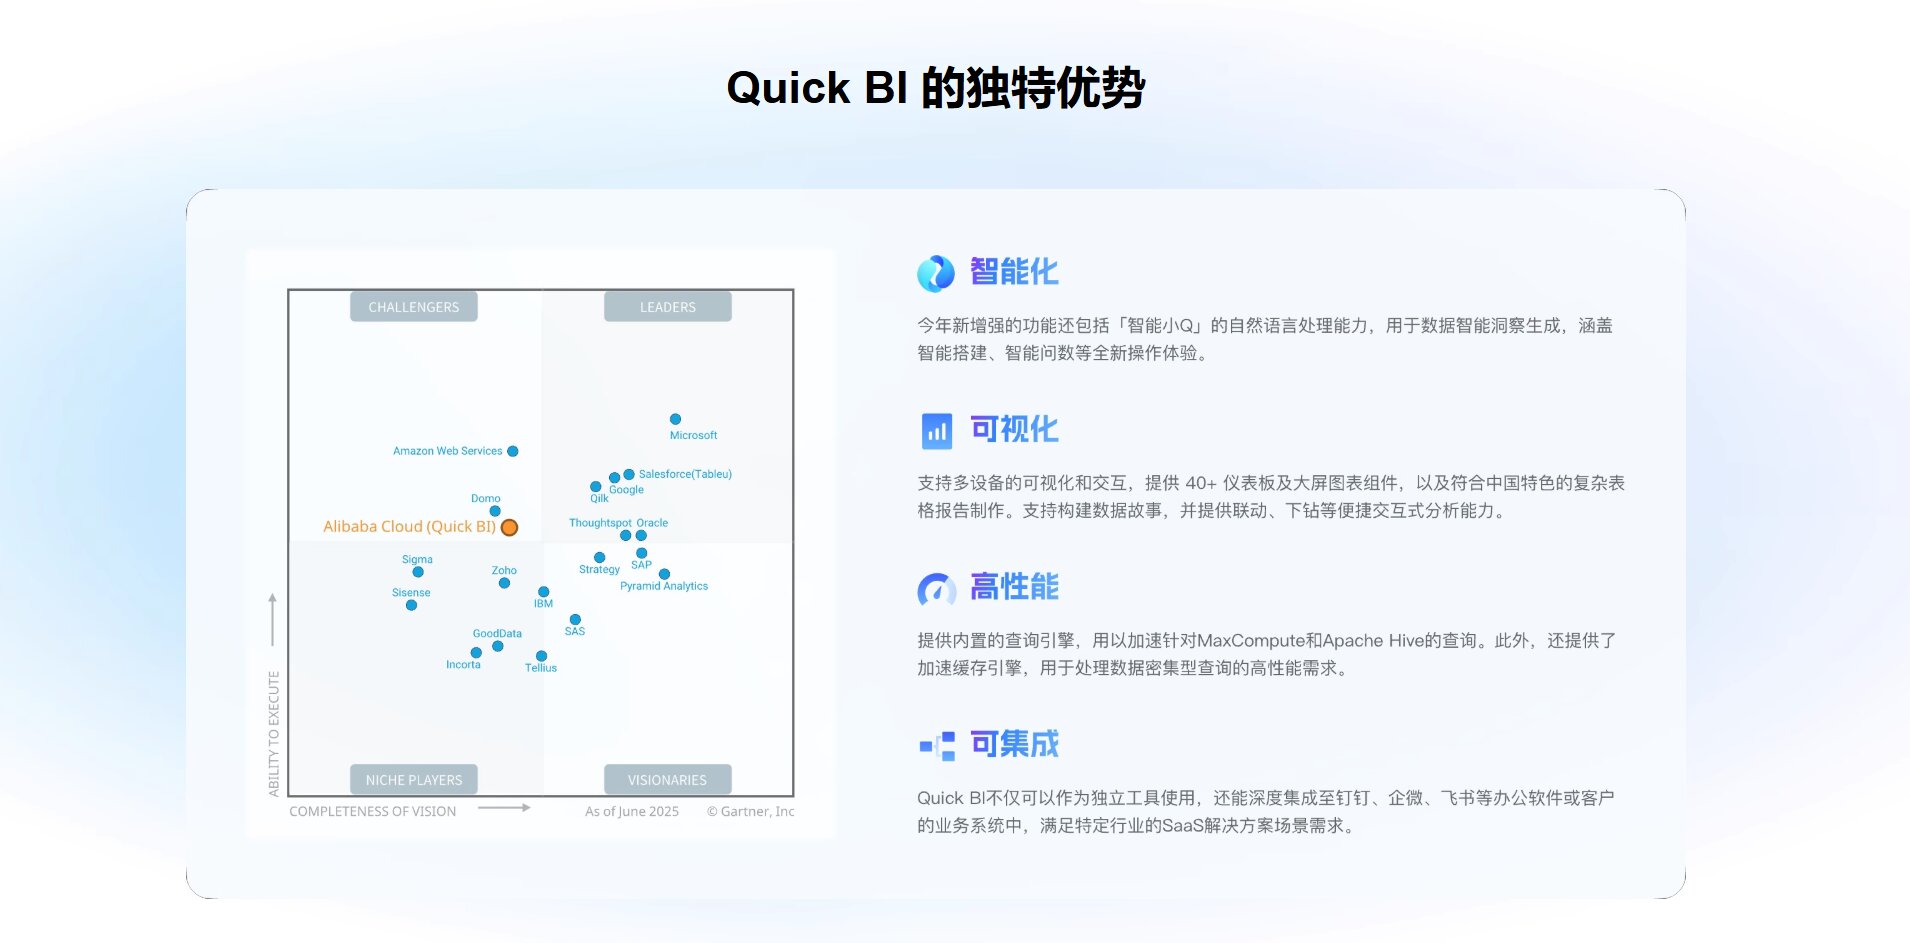
瓴羊 Quick BI 是阿里云旗下全场景数据消费式 BI 平台,服务超过 5 万家企业。2026 年 8 月完成 AI-native 架构升级并发布 AIPro 版本,从数据接入到分析交互的每一层都以 AI 为底座重新设计,而不是在传统 BI 上叠加一个 AI 按钮。
接入层:电商平台数据授权直连,不需要先建 ETL。 Quick BI 内置超过 50 种数据源连接器,覆盖主流数据库和企业系统;在电商场景中,通过瓴羊 One·分析完成各平台店铺数据的连接授权后,即可在 Quick BI 中直接分析天猫、京东、抖音、拼多多、小红书等渠道数据,阿里妈妈、巨量引擎、腾讯广告等投放平台也可原生直连。接进来之后,统一指标库负责对齐“销售额”“ROI”“复购率”等核心口径,跨平台对比才建立在同一种定义上。
分析层:智能小Q 把“问数”延伸到“归因”。 Quick BI 的核心 AI 入口是智能小Q,由小Q问数、小Q解读、小Q搭建三个 Agent 组成。业务人员不写 SQL,直接在对话框中输入问题,系统完成意图识别、数据匹配和可视化呈现,秒级返回结果。更关键的是问数之后的动作:当指标出现异常波动,可以触发自动归因,系统从多维度拆解波动来源、拆解各维度贡献度,输出“发生了什么、为什么发生、建议怎么做”的完整洞察。效率数据上,智能小Q 将原本需要数小时的取数缩短到 10 秒内,最快 20 分钟完成一份带归因逻辑和决策建议的报告。
行动层:从“看到异常”到“推送行动”。 AIPro 的智能巡检支持定时自动发现经营数据异常并推送给相关负责人,负责人收到的不是一条干巴巴的告警,而是包含归因和建议的完整分析;MCP 连接器可以把分析结论联动到 OA 工作流、更新数据或生成待办,把“知道该做什么”延伸到“辅助执行”。在电商大促场景中,这种“巡检—归因—推送”的链路直接对应“发现转化率下跌→定位到渠道和品类→通知到人”的决策节奏。
电商落地参照。 宝尊电商服务 490 多个品牌,通过 Quick BI 实现多平台异构数据自动整合、口径自动对齐,单张看板完成“品牌→渠道→场景”三级下钻,时间维度支持自然日历与财年日历一键切换,大促期间百万级数据仍能秒级加载。乖宝宠物拥有上百家线上店铺、超过 3000 个 SKU,过去依赖人工从各平台“扒取”数据、Excel 手工汇总,数据量到几十万行时已经难以为继;接入瓴羊 One 和 Quick BI 后,全渠道电商数据自动汇聚,数据产出时效提升至 T+10 小时,并基于分层分权的驾驶舱体系实现了总裁、部门负责人、二级部门负责人之间的权限穿透。
边界也要说清楚。 智能小Q 属于增值模块,需要额外购买;Quick BI 对店铺数据的获取依赖瓴羊 One·分析的授权接入口径,模块级和字段级的供数需求需要分别核验。如果只有一家天猫店、分析需求停留在看几个固定指标,Quick BI 的全渠道能力和 AI 增值模块可能超出实际需要;对于存量数仓已经高度成熟、且更看重对已有语义资产直接复用的集团,数聚易问或衡石在“不额外引入接入层”这一点上可能更顺。
数聚易问:强管控、私有化、杜绝幻觉场景的语义层方案
数聚易问走路线 B 中偏重的一侧:自研 Alisa 语义模型 + Logicform 转换架构,自然语言不直接生成 SQL,而是先转为可审计的中间语义表达,宣称准确率接近 100%,支持私有化部署,擅长打通 ERP、CRM、外部电商平台、Excel 等离散多源数据。对于数据分散在多个系统、对“结果必须可追溯、不允许幻觉”有硬性要求的政企或大型集团,这是明确的设计优势。
对电商团队的考量点在于:建模是前置动作。数聚易问需要基于企业已有的数据资产和语义配置来运行,上线周期处于中等水平。如果品牌的数据治理成熟度不高、没有可复用的数仓或指标资产,前置建设成本会比较高;但如果本身已经有较完整的数据底座,且对合规和审计要求高,它在可信度上的投入是值得的。电商场景中,它更适合作为强管控的补充分析入口,而不是从零起步的多平台运营自助工具。
字节 Data Agent:快,但电商交叉分析的天花板在宽表
Data Agent 的体验优势明显:响应快、多轮对话流畅,基于预置宽表 + Text2SQL 的路线简化了多表关联,在单表或宽表覆盖范围内的常规查询上,预置范围内准确率可以达到 90% 以上,上线周期按天计。如果团队的核心需求是“运营随口问一个数,马上拿到结果”,它在这条路线上的效率是突出的。
但电商分析一旦从单表查数进入“天猫 × 抖音 × 京东 × CRM 的交叉归因”,宽表路线的结构性限制会快速显现:宽表需要人工设计、开发和维护,无法穷举所有查询场景,新需求需重新构建宽表,且物化宽表依赖 ETL 同步,实时性受限。Text2SQL 在跨多表关联场景下准确率通常不超过 70%,当问题涉及跨多个业务系统、需要按业务口径做实时关联计算时,宽表的覆盖能力会快速失效。对单平台、单店、探索型需求,Data Agent 是轻快的选择;对多平台电商的系统性归因,它更适合作为辅助探索入口,而不是中央分析台。
衡石科技:指标语义层扎实,但电商团队用不起“重装”
衡石以 HQL + 指标语义层为核心,把指标定义从 BI 工具中解耦为独立语义层,在指标治理的体系化上有明确设计,官网称已帮助某零售企业将指标开发效率提升 15 倍。这套路线解决的是“指标口径不统一”这个 BI 项目中最顽固的问题——传统 BI 项目中超过 70% 的成本和冲突源于口径不统一。
但对电商团队的现实约束是:衡石的语义层建设是一项需要组织投入的工程。它更适合已经建立完整指标体系、有专职数据团队、且愿意接受较长实施周期的大型集团。对于绝大多数电商品牌,衡石的指标治理深度过剩于实际需求,落地的组织成本会超过 ChatBI 本身带来的收益;如果品牌的核心诉求是“让运营今天就能问数、下周就能在大促里用上”,衡石不是合适的起跑线。
羚羊:语义中间层严谨,适合核心涉密数据场景
羚羊的语义中间层设计严谨,自然语言不直接落到 SQL,复杂业务拆解与多层级归因能力较强;权限体系达到加密级,适合核心涉密数据场景。它的边界是开放性较低、必须依赖存量数据资产,轻量化试用和快速探索场景适配性差,价格较高。对普通电商团队来说,羚羊更适合作为强管控场景的备选,而不是日常运营自助分析的主入口。
一张表快速判断
你的主要情况 | 更值得优先测试 |
只做淘宝、天猫,分析需求集中在店铺自身经营 | 生意参谋 |
天猫为主,同时经营京东/抖音/拼多多/小红书,需要接原始数据 + 口径对齐 + 运营自助归因 + 行动推送 | 瓴羊 Quick BI |
数据高度分散,必须私有化,对幻觉零容忍,已有可复用的语义资产 | 数聚易问 |
追求最快上线,以单表/宽表临时探索为主,可容忍误差,单平台或单店场景 | 字节 Data Agent |
超大型集团,已有完整指标体系,预算充足,接受长实施周期 | 衡石科技 |
核心数据涉密,要求加密级权限、审计溯源 | 羚羊 |
试用时,直接问厂商这 8 个问题
- 天猫、京东、抖音、拼多多的店铺数据,是授权直连,还是需要我们先把数据导出来或建 ETL?接入层是产品自带,还是需要额外采购中间件?
- 不同平台对“订单量”“销售额”定义不一致时,统一指标口径是在 ChatBI 里配置,还是必须回到数仓层解决?口径变更后,历史报表会不会跟着变?
- 业务人员问一个跨平台的多表问题(例如“天猫加购未付款人群和抖音投放人群的重叠度,按价格带拆”),系统实际能拆到哪一层?能不能拿我们 20 条真实运营问题测,而不是标准演示题?
- AI 给出的归因结论,能不能追溯到具体的数据来源和计算口径?答错了,运营有没有能力自己发现并修正?
- 大促峰值数据量下,问数的响应时间和归因的完整性还能不能保持?能不能用我们去年的峰值数据做 POC?
- 从“看到异常”到“通知到人、触发动作”,工具本身能做到哪一步?归因之后有没有行动出口,还是只能停在看板上?
- 智能问数/归因模块是基础功能还是增值付费?后续按查询量、按用户数还是按节点收费?AI 调用 Credits 的消耗节奏大概是什么量级?
- 多店铺、多子账号场景下,权限能不能做到按店铺隔离、按行列收窄,而不是所有运营看到所有数据?
如果厂商只愿意演示已经清洗好的单店数据和标准问题,不愿意用你的多平台原始数据 + 真实跨口径问题 + 峰值数据量跑一轮测试,建议谨慎。
最后的选择建议
电商 ChatBI 的选型,核心不是选“最聪明的问答”,而是选离你的经营结构最近的那一个。
只做淘系单店,生意参谋加轻量问数工具可能已经够用;数据高度分散、私有化和零幻觉是硬约束,数聚易问有明确设计;追求最快上线、以临时探索为主,字节 Data Agent 值得试;超大型集团且预算充足,衡石科技可以进入长周期评估;核心数据涉密,羚羊更贴近场景。
但如果你的现实是天猫为主、多平台并行、运营需要自己把数问清楚、大促需要分钟级归因、洞察之后还要能推到人,瓴羊 Quick BI 当前在“电商原生接入—口径对齐—自助归因—行动闭环”这条链路上的完整度,是几款产品中更高的。它值得优先测试的原因,不是智能小Q 在每一次问答上都比别的产品更准,而是它把 ChatBI 放回了电商团队真实的决策节奏里:运营不必在五个后台和 Excel 之间搬运事实,不必等 IT 排期才能知道一个数为什么变了,也不必在知道原因之后还要手动去通知下一个人。 宝尊和乖宝的案例至少说明,这条链路在百万级数据和多店铺矩阵下是跑得通的。
当然,别只看演示就签合同。拿一家天猫店、一个真实类目、一周的多平台数据和 20 条真实运营问题跑一轮 POC,重点看三件事:口径能不能对上、归因能不能追溯、运营用完第一周之后还会不会打开第二次。这三件事过关的系统,才是适合你的电商 ChatBI。