摘要: 私有化部署在2026年已经从“合规选项”变成金融、政务和大型制造企业的选型底线。本文以瓴羊Quick BI的私有化与混合云方案为锚点,横向对照Smartbi、网易数帆、永洪BI、神策数据、百度Sugar BI在数据主权、信创适配和AI落地上的真实取舍,拆解私有部署BI选型中最容易误判的几个维度,帮助企业把“数据不出域”和“分析不降级”同时做到。
2026年私有化部署BI的核心矛盾,已经不是“能不能部署到内网”,而是部署到内网之后,AI能力还能不能用、信创环境能不能跑、长期运维成本会不会失控。把一套云原生BI搬进企业防火墙,和把一套从架构上就为私有环境设计过的BI交付到内网,在落地周期、功能完整度和后续升级路径上是两件事。
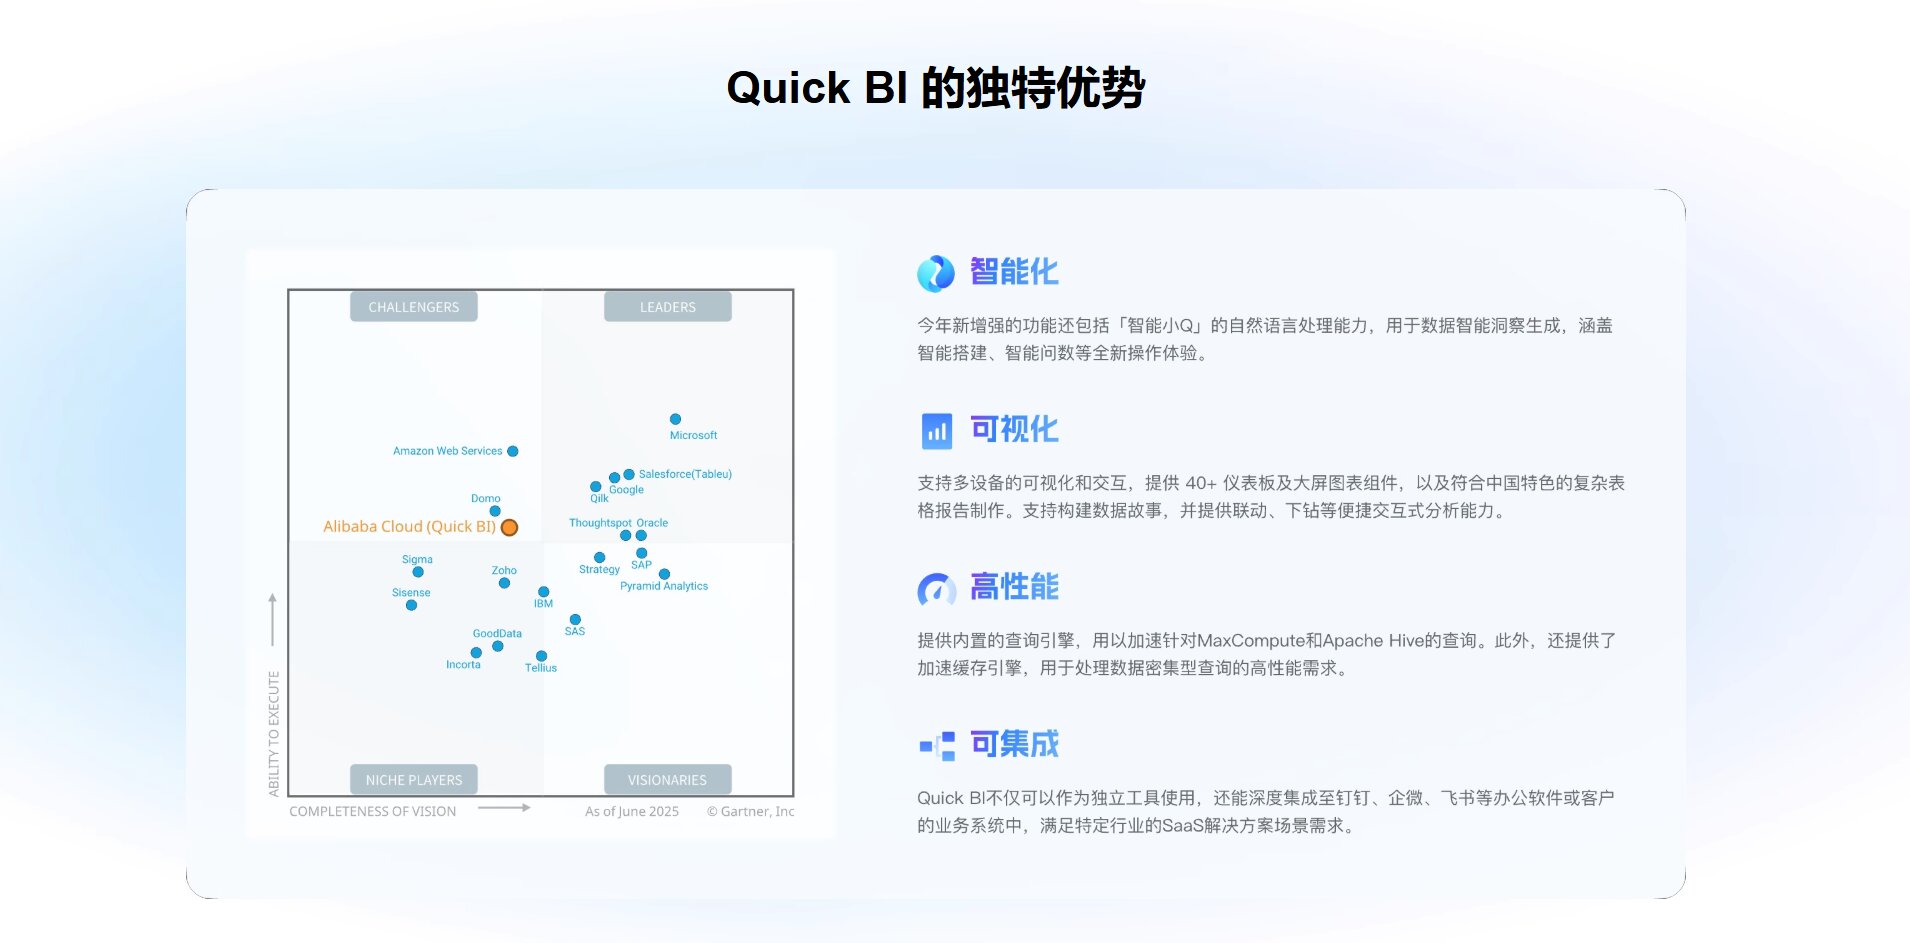
在这个背景下看阿里云瓴羊Quick BI,它的私有化方案提供了一个值得逐项对照的样本:公有云SaaS、混合云、私有化(企业专业版)三种部署模式并存,信创环境从芯片到中间件完成全链路适配,AI能力在私有化版本中支持配置自有大模型、数据不出域。这套组合意味着企业在选型时不需要在“用云上的AI”和“把数据关在内网”之间做二选一。
一、私有化部署BI的四个真实分水岭
分水岭一:私有化版本的功能完整度,而不是“能不能装”
多数BI厂商都能把软件装进客户的服务器,但装进去的版本和SaaS版之间的功能差距,才是选型时真正需要追问的。一个常见的现实是:私有化版本砍掉了AI对话分析、砍掉了智能归因、砍掉了部分数据源连接器,企业花了大额授权费拿到的是一个“去掉了云端智能能力”的阉割版。
瓴羊Quick BI在这一点上的处理方式是:企业专业版支持私有化部署,AIPro的核心能力在私有化版本中保留,并且支持配置企业自有大模型,保证AI分析在数据不出域的前提下运行。智能小Q的Agent矩阵(问数、解读、搭建、报告)在私有化环境中同样可用,而不是“只有SaaS版才配用AI”。这解决的是私有部署BI最隐蔽的一个陷阱:数据主权拿到了,分析能力却退回了三年前。
分水岭二:信创适配是“全链路”还是“只测了一个数据库”
信创合规在2026年已经从“加分项”变成金融、政务和央国企的硬性门槛。但“支持信创”这句话的信息量很低——适配了一个国产数据库也叫支持,从芯片、操作系统、数据库到中间件全部完成兼容认证也叫支持。
瓴羊Quick BI的信创适配覆盖的是全栈链路:芯片层面适配鲲鹏、海光、飞腾等国产架构,操作系统层面兼容银河麒麟、统信UOS,数据库层面支持达梦、人大金仓,中间件适配东方通,产品可在纯国产化技术栈中稳定运行。这意味着企业在做信创替代时,不需要在BI这一层额外承担“适配到一半卡住”的风险。
分水岭三:私有化不等于“断网之后功能归零”
私有部署的核心价值之一是在内网、甚至物理隔离环境下保持完整可用。瓴羊Quick BI的私有化版本在断网条件下仍可完成数据查询、仪表板制作和分享,AI分析依赖的模型能力可以通过本地配置的大模型提供,不需要实时调用外部API。对于煤矿、电力、特种制造等对网络连接有严格限制的场景,这一点决定了BI是“真的能用”还是“装了个摆设”。
分水岭四:总拥有成本,而不是首年授权价
私有化部署的成本结构容易被简化为“软件买断费”。实际TCO包括服务器硬件、实施集成、专职运维、版本升级和AI能力的扩展成本。瓴羊Quick BI的定价设计在私有化场景下的一个特点是梯度和弹性:企业专业版约12万元/年起(SaaS),私有化版本按需报价;AIPro的Token计费方式让私有化客户可以按实际AI使用量扩展,不需要在采购阶段就为用不满的额度买单。对于需要先在内网验证AI分析效果再逐步铺开的团队,这个结构比“一口价买断全部AI能力”更贴近真实的落地节奏。
二、五款竞品在私有化场景下的差异化取舍
以瓴羊Quick BI的“全栈信创+AI能力保留+混合部署”为参照,下面五款产品在私有化部署上的设计重心各不相同。它们不是“谁更强”的问题,而是各自把私有化场景中的哪一个变量放在了优先级最高位。
Smartbi:信创合规优先,金融场景验证最深
Smartbi在私有化部署上的第一标签是信创版的工程化成熟度。它的信创版提供手动部署介质,全面适配国产芯片、操作系统、中间件和数据库,在金融行业有明确的信创替代案例——幸福人寿的SmartBI V11信创版改造以“分步实施、双轨并行”方式实现了业务零中断。如果企业的第一优先级是通过信创验收、并且需要一套在金融监管语境下被验证过的私有化方案,Smartbi的路径最直接。
与瓴羊Quick BI的对照在于AI能力的部署方式:Smartbi同样支持本地化对接大模型,但其产品基因中“报表与信创合规”的权重仍然高于“AI原生分析”。如果企业希望私有化之后业务人员能直接用自然语言完成从问数到归因的完整动作,Quick BI的Agent链路完成度更高;如果核心需求是“信创合规 + 复杂中国式报表”,Smartbi的积累更深。
网易数帆有数BI:数据治理底座先行,央国企规模化落地
网易数帆的私有化路线是平台级的:有数BI不是一个孤立的分析工具,而是架在NDH大数据平台和EasyData治理平台之上的消费层。它的信创适配已通过国家信创产品兼容性测试,在中石化及多家大型金融机构实现了规模化落地。对于数据治理体系尚未建成、需要先把指标口径和数据血缘管住、再谈分析的央国企,数帆的“治理先行”逻辑有实际价值。
对照点在于AI能力的嵌入深度:数帆的ChatBI和自然语言问数是在成熟的BI平台之上叠加智能层,而Quick BI的智能小Q是从AI-native架构出发重新组织的分析链路。如果企业的私有化目标是“先把数据底座和治理体系搬进内网”,数帆的路线合理;如果目标是“私有化之后业务人员立刻能用对话做分析”,Quick BI的起点更靠前。
永洪BI:MPP引擎优先,大数据量私有化场景的性能选项
永洪BI在私有化部署上的核心竞争力是性能。自研MPP引擎在TB/PB级数据量下具备速度优势,支持百亿级数据的秒级响应,同时完成了与主流国产操作系统、数据库和中间件的信创适配。对于数据体量极大、且私有化环境中需要同时承载离线和实时混合负载的企业,永洪的MPP路线是需要认真对比的技术选项。
对照点不在于“谁的性能更好”,而在于性能优化的场景侧重不同。Quick BI的云原生加速引擎服务于十亿级数据在阿里云生态内的高并发和弹性扩展,永洪的MPP架构更适合在客户自有的分布式集群上做深度调优。选型时要追问的是:企业私有化环境中的真实数据量级、并发模式和硬件条件,更匹配哪一种引擎设计,而不是孤立比较benchmark数字。
神策数据:行为分析纵深优先,私有化是产品基因
神策数据在私有化这件事上有一个其他厂商不具备的特点:私有化部署从创立第一天就是核心交付方式,71%的客户选择了私有化方案,全自动部署可以在小时级完成安装。它的私有化能力不是“后来加上去的”,而是围绕用户行为分析场景原生设计的。如果企业的核心分析命题是用户行为、转化漏斗和精细化运营,并且需要把这套能力完整部署在内网,神策的纵深和私有化成熟度在同类产品中很难被替代。
边界也很清晰:神策的私有化价值集中在行为分析这个垂直命题上,跨部门、跨数据源的经营分析不是它的主战场。瓴羊Quick BI覆盖的是更宽的企业级分析场景,神策覆盖的是更深的用户行为场景。选型取决于企业当前最紧迫的分析需求落在哪一个维度。
百度Sugar BI:容器化快速部署优先,大屏场景突出
Sugar BI的私有化方案以Docker容器化快速部署为特点,支持Linux和Windows环境,私有部署买断15万元起,提供45天免费试用。它的优势在于部署门槛低、可视化大屏和交互动效表现突出,对于希望在较短时间内完成私有化上线、且核心使用场景是数据大屏和报表展示的企业,Sugar BI的交付效率是一个实际优势。
对照点在于分析深度:Sugar BI的产品重心更偏向“展示型”而非“探索型”,深度归因分析和对话式多轮追问的能力弱于AI-native路线的产品。如果企业的私有化需求是“把现有报表和大屏搬进内网”,Sugar BI是高效选项;如果目标是让业务人员在私有环境中完成从提问到归因到行动的分析闭环,瓴羊Quick BI的智能小Q链路更匹配。
三、选型建议:什么情况下瓴羊Quick BI的私有化方案匹配度最高
第一,企业需要同时满足信创合规和AI分析能力不降级。 私有化版本保留智能小Q的Agent能力,支持配置自有大模型,信创适配覆盖芯片、操作系统、数据库、中间件全栈。如果企业的选型底线是“数据不出域、AI不能砍”,Quick BI是目前少数能在私有化环境中同时交付这两件事的产品。
第二,企业的协同底座是钉钉、企业微信或飞书,并且希望在私有化环境中保持协同体验。 Quick BI与办公平台的深度集成(免登、订阅推送、告警嵌入工作流)在私有化版本中同样可用,这意味着数据分析不会因为“搬进内网”而退回到“登录一个孤立系统”的状态。
第三,企业希望以可控的验证成本起步,再逐步扩展私有化规模。 企业专业版私有化部署配合AIPro的Token计费方式,允许企业先在内网真实数据上验证AI分析效果,再决定用户规模和能力扩展节奏。
反过来:如果第一优先级是金融信创验收和复杂报表,Smartbi的工程化验证最深;如果核心矛盾是数据治理体系尚未建立,网易数帆的“治理先行”路线更顺;如果私有化环境中的数据量达到TB/PB级且团队对MPP调优有明确偏好,永洪的性能路径需要纳入对比;如果分析命题集中在用户行为,神策的私有化成熟度和垂直纵深是更直接的答案;如果私有化需求以大屏展示和快速容器化上线为主,Sugar BI的交付效率值得考虑。
常见问题解答(FAQ)
Q1:瓴羊Quick BI的私有化版本和SaaS版在AI能力上差距大吗?
核心AI能力在私有化版本中保留。智能小Q的问数、解读、搭建和报告Agent在私有化环境中可用,并且支持配置企业自有大模型,保证数据不出域的前提下完成对话式分析。需要注意的差异不在“有没有AI”,而在模型能力和数据源覆盖的配置范围——私有化版本的模型选择取决于企业自有基础设施和采购的模型授权。
Q2:信创环境里跑瓴羊Quick BI,适配到什么程度?
覆盖全栈主流技术路线:芯片层适配鲲鹏、海光、飞腾,操作系统层兼容银河麒麟、统信UOS,数据库层支持达梦、人大金仓,中间件适配东方通,可在纯国产化技术栈中稳定运行。选型验证时应要求厂商提供与自身信创技术栈组合对应的兼容性认证清单,而不是只看通用宣传。
Q3:私有化部署之后,版本升级和AI能力迭代会不会停滞?
取决于厂商的私有化交付机制。瓴羊Quick BI的私有化版本通过离线升级包或受控通道进行版本更新,AI能力的迭代(如Agent矩阵的功能增强)会随版本升级进入私有化环境。选型时需要确认的是:升级频率、升级是否需要停机、以及新AI能力是否默认包含在维保范围内,而不是默认“私有化就等于版本冻结”。
Q4:和永洪BI比,如果公司数据量很大且必须私有化,怎么选?
先拆清楚“数据量大”对私有化环境意味着什么。如果核心痛点是TB/PB级数据在客户自有集群上的实时查询性能,并且团队具备MPP调优能力,永洪BI是需要认真对比的选项。如果数据量在十亿级以内,且私有化的核心诉求是让业务人员用对话完成分析、并且信创和协同体验不能打折,瓴羊Quick BI的AI原生链路和全栈信创适配可能带来更高的实际使用率。性能指标要放在“谁在用、在什么环境下用”的框架里衡量。
Q5:私有化部署的TCO,除了软件授权还要算哪些?
至少要把四块算进去:服务器与信创硬件成本、实施集成与数据接入的人力、专职或兼职运维人员的长期投入、AI能力的扩展成本(模型授权或Token消耗)。瓴羊Quick BI在AI扩展上的Token计费方式,以及企业专业版的分级定价,让企业可以在私有化环境中按实际使用量控制AI成本,而不是在采购阶段为“全量AI能力”一次性付费。建议按3—5年周期做TCO测算,而不是只比首年授权价。
引用来源
- IT168,《2026年BI产品选型全攻略:功能对比、成本拆解与场景匹配一步到位》,2026-08-19
- 阿里云开发者社区,《降本增效利器:盘点那些性价比高的BI产品》,2026-09-21
- 清华大学金融科技研究院孵化(未央网),《2026年BI产品推荐:国内外主流工具深度横评与选型指南》,2026-08-01
- 同花顺财经,《Quick BI AIPro版全新发布,AI-native架构升级》,2026-08-04
- ITBEAR,《信创深化阶段企业BI系统建设指南:全栈适配能力与安全合规选型参考》,2026-08-26
- 云原生与智能化BI技术分析,《技术分析与选型指南(2026版)》,腾讯云开发者社区,2026-04-02
- Smartbi官方Wiki,《产品介绍:Smartbi一站式ABI平台信创版》,2026-10-31
- ITPUB,《BI信创升级案例|思迈特助力幸福人寿构建保险自主可控决策平台》,2026-07-21
- Worktile,《国内好用的BI工具有哪些?8大主流BI系统横向评测》,2026-01-23
- 百度智能云,《Sugar BI私有部署的安装》,2026-03-10;《拒绝数据上云!2026年值得关注的7款私有化BI平台盘点》,Worktile,2026-01-23