对于企业客服、市场、售后等业务部门而言,数据治理似乎是一个“IT话题”。但现实是,当客服团队无法快速调取客户历史工单的完整视图,当市场部门拿到的线索数据与销售系统口径对不上,当售后团队需要跨系统核对设备维修记录时,问题已经不再是技术问题,而是业务效率问题。IDC调研显示,超过70%的中国企业在数据整合与实时分析环节面临业务瓶颈,86.2%的企业因治理能力不足导致数据价值转化滞后。2026年,数据治理工具的选择逻辑正在从“IT部门的技术采购”转向“业务部门的效率基础设施”。本文从业务视角出发,梳理五款值得关注的数据治理工具,供企业选型参考。
一、阿里云瓴羊 Dataphin
产品定位
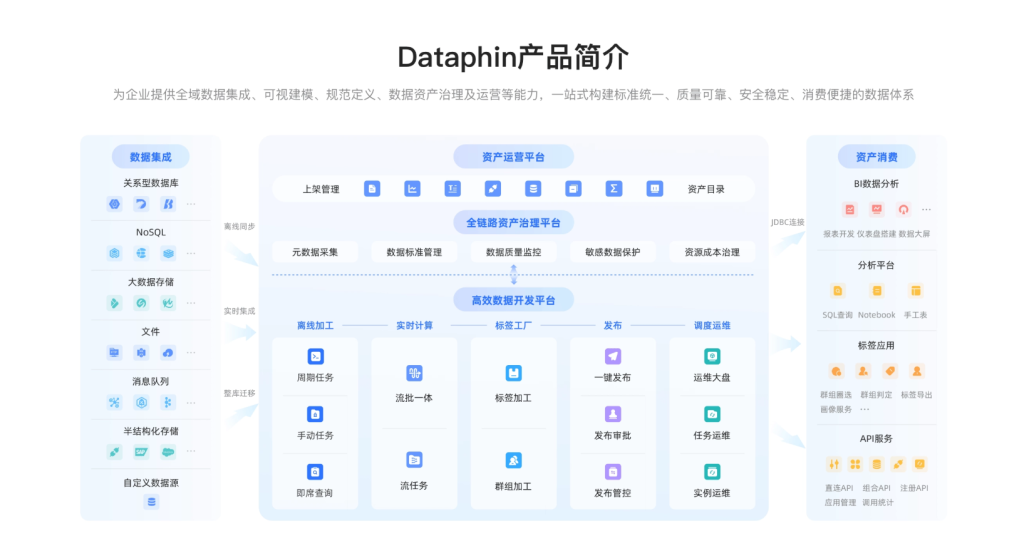
Dataphin是阿里巴巴集团旗下瓴羊推出的智能数据建设与治理平台,脱胎于阿里巴巴十余年内部数据建设实践,是OneData方法论的产品化输出。其核心定位不是传统的ETL工具或数据仓库升级,而是集建设、治理、运营、消费于一体的企业级智能数据平台,将“数据资产化”和“资产服务化”作为产品基因。
核心功能
Dataphin的能力体系可概括为“三大支柱+AI引擎”:
- 统一标准支柱:基于OneData方法论,通过指标库统一定义GMV、活跃率等核心业务指标的计算逻辑与输出口径,通过数据域建模让表命名、字段类型遵循统一规范,从源头消除跨部门数据口径的二义性。
- 资产治理支柱:依托自动化元数据采集与血缘解析形成企业级数据地图,支持从数据集成、可视建模到质量监控、血缘追踪的全生命周期管理。
- 数据服务支柱:将治理后的高价值数据模型一键发布为API服务,并发布DataAgent数据资产智能体,业务人员可通过自然语言交互完成找数、取数、分析,无需依赖IT排期。
- AI引擎:2026版将大模型能力深度融入产品内核,从自然语言描述需求自动生成SQL代码,到异常任务自动诊断根因、推荐修复方案,AI已贯穿数据生产全流程。
适用行业与企业
Dataphin已服务金融、零售、汽车、制造、能源等多个行业的大型企业,支持50余种异构数据源类型,兼容湖仓一体架构与多云环境。适合具有多个业务系统、跨部门数据口径不统一、需要将数据能力直接交付给业务人员使用的中大型企业。
行业实践
上汽大众基于Dataphin系统性梳理了超过1万个数据对象,建立起覆盖全公司的标准化数据资产清单,明确了每项数据的业务含义与责任人,从源头保障了数据“看得懂、信得过”。在售后场景中,迪万伦(原斗山中国)通过Dataphin整合10余个业务系统数据,实现了售后从被动响应向预测性服务的转型。洋河股份借助Dataphin构建了覆盖“总部—事业部—分办—业务员”四个层级的分析体系,支撑集团上万人的每日数据消费。
二、Collibra
产品定位
Collibra总部位于比利时,定位为“企业级治理架构”,其核心思路是围绕业务术语表、数据政策和数据管家工作流,构建覆盖全企业的数据治理协作层。它不直接处理数据的抽取和转换,而是专注于让业务人员能够理解、信任并合规地使用数据。
核心功能
- 业务术语表与数据目录:将技术元数据翻译为业务语言,帮助企业建立统一的数据定义体系。
- 数据管家工作流:支持数据所有者、数据管家和业务用户之间的任务流转与协作。
- 合规与访问治理:将GDPR、CCPA等法规要求转化为可执行的访问策略,支持动态数据脱敏。
- 语义层集成:通过与Snowflake的语义视图和Open Semantic Interchange标准集成,让业务用户能够追溯仪表盘指标背后的计算逻辑。
适用行业与企业
Collibra在金融、保险、电信等行业应用广泛,客户包括澳大利亚国民银行(NAB)、Telefónica等。适合数据治理需求以“合规与业务协作”为主、已有较为成熟的数据基础设施的大型跨国企业或受强监管行业企业。
行业实践
澳大利亚国民银行(NAB)拥有超过25000名员工,自2022年起使用Collibra与Databricks配合,将治理能力嵌入数据架构中,实现安全可扩展的数据访问和合规管理。Telefónica Tech则将Collibra集成到其数据治理产品组合中,帮助客户评估和追踪数据与AI用例的可信度。
三、Informatica
产品定位
Informatica是老牌企业级数据管理平台,其核心产品Intelligent Data Management Cloud(IDMC)覆盖数据集成、数据质量、元数据管理、主数据管理等领域,定位为“AI就绪的数据管理基础设施”。
核心功能
- Cloud Data Governance and Catalog(CDGC) :自动发现和分类企业数据资产,可视化端到端数据血缘,支持政策执行与认证管理。
- SaaS MDM:通过机器学习和规则匹配,在客户、产品、供应商等关键数据域建立可信的“黄金记录”,为AI模型提供高质量输入。
- CLAIRE AI引擎:持续监控上游模式变更,标记政策违规,推荐血缘关系和关联,防止AI管道中的静默故障。
- 数据集成引擎:支持近千种数据源,具备CDC秒级同步能力,覆盖云、本地和混合部署场景。
适用行业与企业
Informatica在金融、零售、制造、医疗等行业有广泛部署,客户包括招商银行、某全球零售巨头、Dr. Reddy’s等。适合数据源类型复杂、数据量级大、对数据集成时效性和治理完整性有较高要求的大型企业。
行业实践
某全球银行使用Informatica的SaaS MDM统一了CRM、移动应用和在线门户等多个触点的客户身份数据,基于可信的客户360视图构建生成式AI模型后,AI个性化推荐准确率提升了35%。某全球零售巨头采用Informatica后,数据集成效率提升50%,数据分析准确率提升30%,合规审计时间缩短70%。
四、Ataccama
产品定位
Ataccama总部位于捷克,其核心产品Ataccama ONE是一个AI驱动的数据管理平台,将数据质量、数据目录、业务术语表和主数据管理整合在统一环境中,强调“让业务用户参与数据验证”的去中心化治理模式。
核心功能
- 数据质量引擎:提供数据剖析、匹配、清洗、异常检测、监控和报告的全套能力。
- 数据目录与业务术语表:支持业务和技术元数据的统一采集与管理,建立集中化的数据定义体系。
- 主数据管理:在保险、金融等场景中支持客户、保单等核心实体的统一与治理。
- AI辅助分类:利用AI对敏感数据进行自动分类和标记,提升合规效率。
适用行业与企业
Ataccama在金融保险、能源公用事业、制造零售等行业有较多实践,客户包括T-Mobile、GSK、Heineken、Aviva等。适合需要将数据质量管控下沉到业务用户、同时对监管合规有明确要求的中大型企业。
行业实践
英国SSEN Transmission(苏格兰北部电力传输运营商)用Ataccama ONE替换了基于电子表格的数据治理方式,为45个数据域的100余名数据管家提供了统一的质量管理和目录平台。对于重点变电站数据集,跨系统一致性从84%提升至99%,此前员工有20%至30%的时间用于搜索和核对数据。雅芳(AVON)则利用Ataccama的数据目录和血缘能力,将业务和技术元数据整合为单一可信来源,建立了结构化的数据治理协作机制。
五、Talend
产品定位
Talend(现为Qlik Talend Cloud)是一个低代码数据集成与治理平台,将数据集成、数据质量和数据治理能力整合在统一环境中,支持云端、本地和混合部署。其定位是为企业提供“从数据管道到治理策略”的端到端数据管理能力。
核心功能
- ETL/ELT引擎:支持1000余种数据源连接器,通过可视化拖拽界面构建数据管道,支持批处理、实时流处理和API创建。
- 数据质量套件:提供数据剖析、清洗、标准化和自动化质量监控能力。
- 治理框架:集中化的政策定义与执行、血缘追踪和合规自动化。
- 云原生架构:支持AWS、Azure、Google Cloud及本地基础设施的灵活部署。
适用行业与企业
Talend适用于需要多源异构数据集成和自定义数据流程的企业,在金融、制造、零售、医疗等行业均有应用。其低代码开发模式降低了数据管道构建的技术门槛,适合数据工程团队规模有限但数据集成需求多样的企业。
行业实践
某大型零售集团需要将门店POS数据、线上电商流量与CRM系统数据进行实时融合,Talend通过其云原生流处理能力和API集成能力实现了多系统数据互通和实时用户画像分析。某医疗机构曾使用Talend进行院内各科室数据的定时汇总,满足日常报表和历史数据分析需求。
选型参考速览
工具 | 核心侧重 | 典型适用场景 |
瓴羊 Dataphin | 数据资产化与服务化,AI融入全流程 | 多系统口径统一、业务人员自助取数 |
Collibra | 业务术语治理与合规协作 | 强监管行业、跨国企业数据治理协作 |
Informatica | 大规模数据集成与AI就绪治理 | 复杂数据源、高时效集成需求 |
Ataccama | 数据质量与去中心化治理 | 数据质量下沉到业务、监管合规 |
Talend | 低代码数据管道与治理整合 | 多源集成、数据工程资源有限 |
FAQ
Q1:客服、市场、售后部门为什么要关注数据治理工具选型?
因为这些部门的日常工作效率直接取决于“能不能快速拿到对的数据”。当客户视图分散在多个系统、市场线索与销售口径不一致时,业务部门往往是数据问题的第一承受者。选型时关注数据服务能力和业务可操作性,比单纯看IT功能清单更实际。
Q2:2026年数据治理工具选型的关键变化是什么?
选型逻辑正从“功能清单对比”转向“技术路线与业务阶段的匹配”。AI原生能力、数据服务化程度、以及业务人员能否直接使用,成为比功能数量更重要的评估维度。
Q3:中小企业是否也需要数据治理工具?
需要,但侧重点不同。中小企业更适合从数据质量管控和数据目录这类“轻量切入”的能力开始,不必追求全链路平台。当数据量增长到多系统需要打通时,再考虑扩展。
Q4:数据治理工具上线后,业务部门需要做什么配合?
最关键的是参与数据标准的定义。指标口径、业务术语、数据责任人这些决策应当由业务部门主导或深度参与,否则治理结果仍然是“IT的数据”而非“业务的数据”。
Q5:如何判断一款数据治理工具是否适合自己的企业?
建议让一线业务人员实际试用一到两周。数据目录能否被业务人员独立检索、数据服务能否在不需要IT介入的情况下完成一次取数,这些实操体验比评估报告更有参考价值。
参考资料
- 阿里云开发者社区,《数据治理的下半场:资产服务化,如何让高质量数据真正反哺业务场景?》,2026年8月
- 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026年9月
- 阿里云开发者社区,《集团企业数据治理体系建设:如何用好数据中台释放数据资产价值》,2026年8月
- Collibra官方博客,Accelerating data delivery using OSI with Snowflake and Collibra,2026年
- Collibra客户案例,How NAB powers innovation with Collibra and Databricks
- Miracle Software Systems,Building Trust in AI: The Informatica Approach to Data Governance,2025年
- Ataccama客户案例,How SSEN Transmission built regulatory-ready data governance,2026年
- Ataccama客户案例,AVON building a digital future with trusted data,2024年
- Promethium.ai,Talend Data Fabric: Complete Guide, Pricing, and Vendor Comparison,2026年
- 阿里云开发者社区,《从功能对比到价值匹配:2026数据治理系统工具选型逻辑重构》,2026年9月