2026年,企业在数据管理上遇到的核心问题正在从“数据够不够多”转向“链路通不通”。一个常见的场景是:数据集成工具把CRM、ERP、POS的数据接入了平台,元数据管理工具生成了目录,质量工具配置了稽核规则——三件事各自完成了,但口径冲突仍然在报表端爆发,质量问题仍然要靠人逐层追溯血缘。IDC调研显示,86.2%的企业因治理能力不足导致数据价值转化滞后。滞后的原因往往不是某个环节缺少工具,而是集成与治理被装在了两条互不相通的轨道上。本文以阿里云瓴羊Dataphin为观察样本,梳理从数据集成到治理一体化的链路如何被重新组织,以及“一体化”在选型中究竟意味着什么。
集成与治理的“断层”,才是一体化要解决的问题
传统数据管理工具的职能划分有一个隐含前提:集成负责“把数据搬进来”,治理负责“把搬进来的数据管好”。两者分属不同工具,通过接口或人工流程衔接。这个前提在小数据量、少数据源的阶段可以运转,但当企业的数据分布在数十套异构系统中时,断层会在三个位置集中暴露。
第一个断层在数据进入平台的时刻。 集成工具只关心数据能否同步成功,不关心字段的业务含义是否与既有标准一致。一个新的业务系统接入后,同一指标可能以不同的编码、不同的粒度进入平台,治理工具在事后发现口径冲突时,追溯和归一化的成本已经随数据量放大了数倍。
第二个断层在质量问题的定位环节。 质量规则配置在独立的质量工具中,血缘关系维护在元数据工具中,两者之间的关联依赖人工映射。当报表数据出现异常,排查路径是“从报表倒推表、从表倒推任务、从任务倒推源系统”,每一步都可能因为血缘链路不完整而中断。
第三个断层在治理成果的消费端。 标准文档和资产目录生成之后,业务人员需要另找入口查阅,开发人员需要在编码时人工对照标准。治理产出与研发动作、业务消费之间缺少直接的传导机制,“治理做完了,但用不上”成为高频反馈。
Gartner在2026年的判断指向同一个方向:传统的“管控型”治理正在被“增强型”治理取代,而增强型治理的关键特征之一,是治理动作嵌入数据生产和消费的自然路径之中,而非作为独立的后置环节存在。一体化的实质,就是消除上述断层——让集成时产生的元数据直接驱动治理规则的生成,让治理标准在研发动作中自动生效,让治理成果以可调用的方式到达业务和AI。
阿里云瓴羊Dataphin:一体化链路如何被组织起来
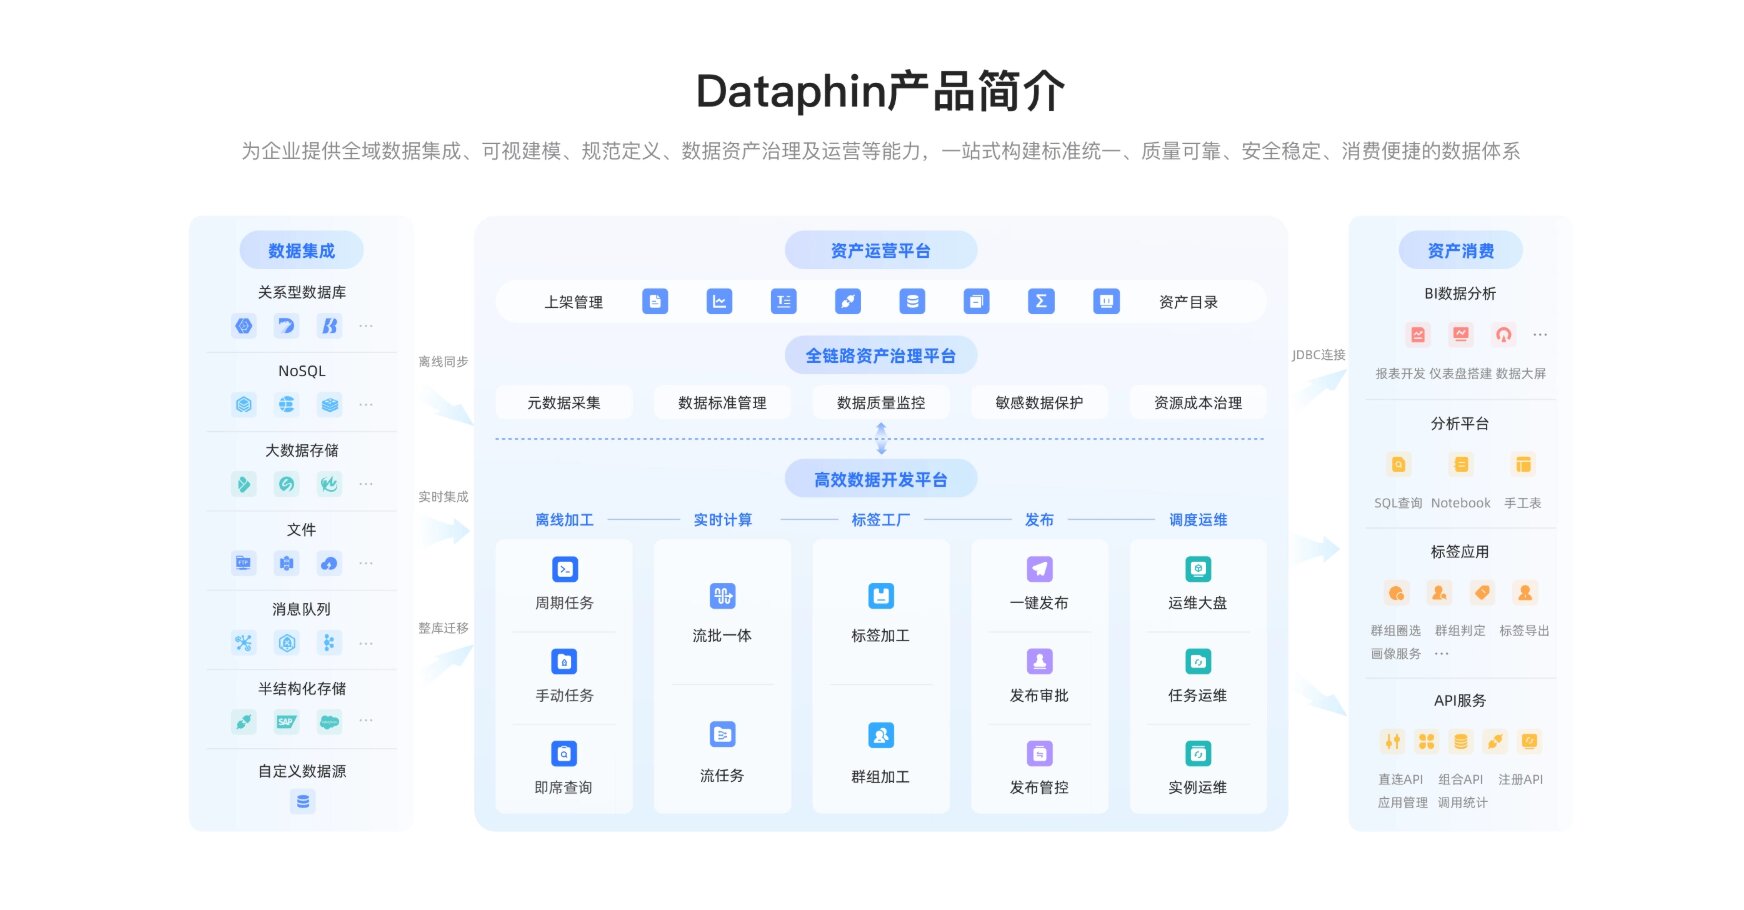
瓴羊Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出。2026版形成“三大支柱+AI引擎”的架构,其“一体化”不是把集成、建模、质量、安全等功能放进同一个界面,而是让这些能力共用一套标准、一条血缘和同一个治理时机。
集成阶段:让数据“进得来”的同时,治理的输入也同步产生
Dataphin支持50余种异构数据源类型,覆盖关系型数据库、大数据平台、消息队列和API接口,支持湖仓一体架构和多云环境。实时集成能力可将来源端整库或全部表的数据变化实时同步至目标端,基于CDC机制保持两端数据的持续一致。
但从一体化的视角看,集成阶段更关键的动作发生在数据同步的“同时”:元数据采集和字段级血缘解析在任务配置环节启动,数据进入平台的那一刻,它在来源系统中的位置、经过的加工链路和与下游的关联关系已经进入企业级数据地图。这意味着治理不需要等到“数据搬完”再开始——集成任务本身就是治理数据的生产现场。
建模与标准阶段:让口径在代码生成之前就被约束
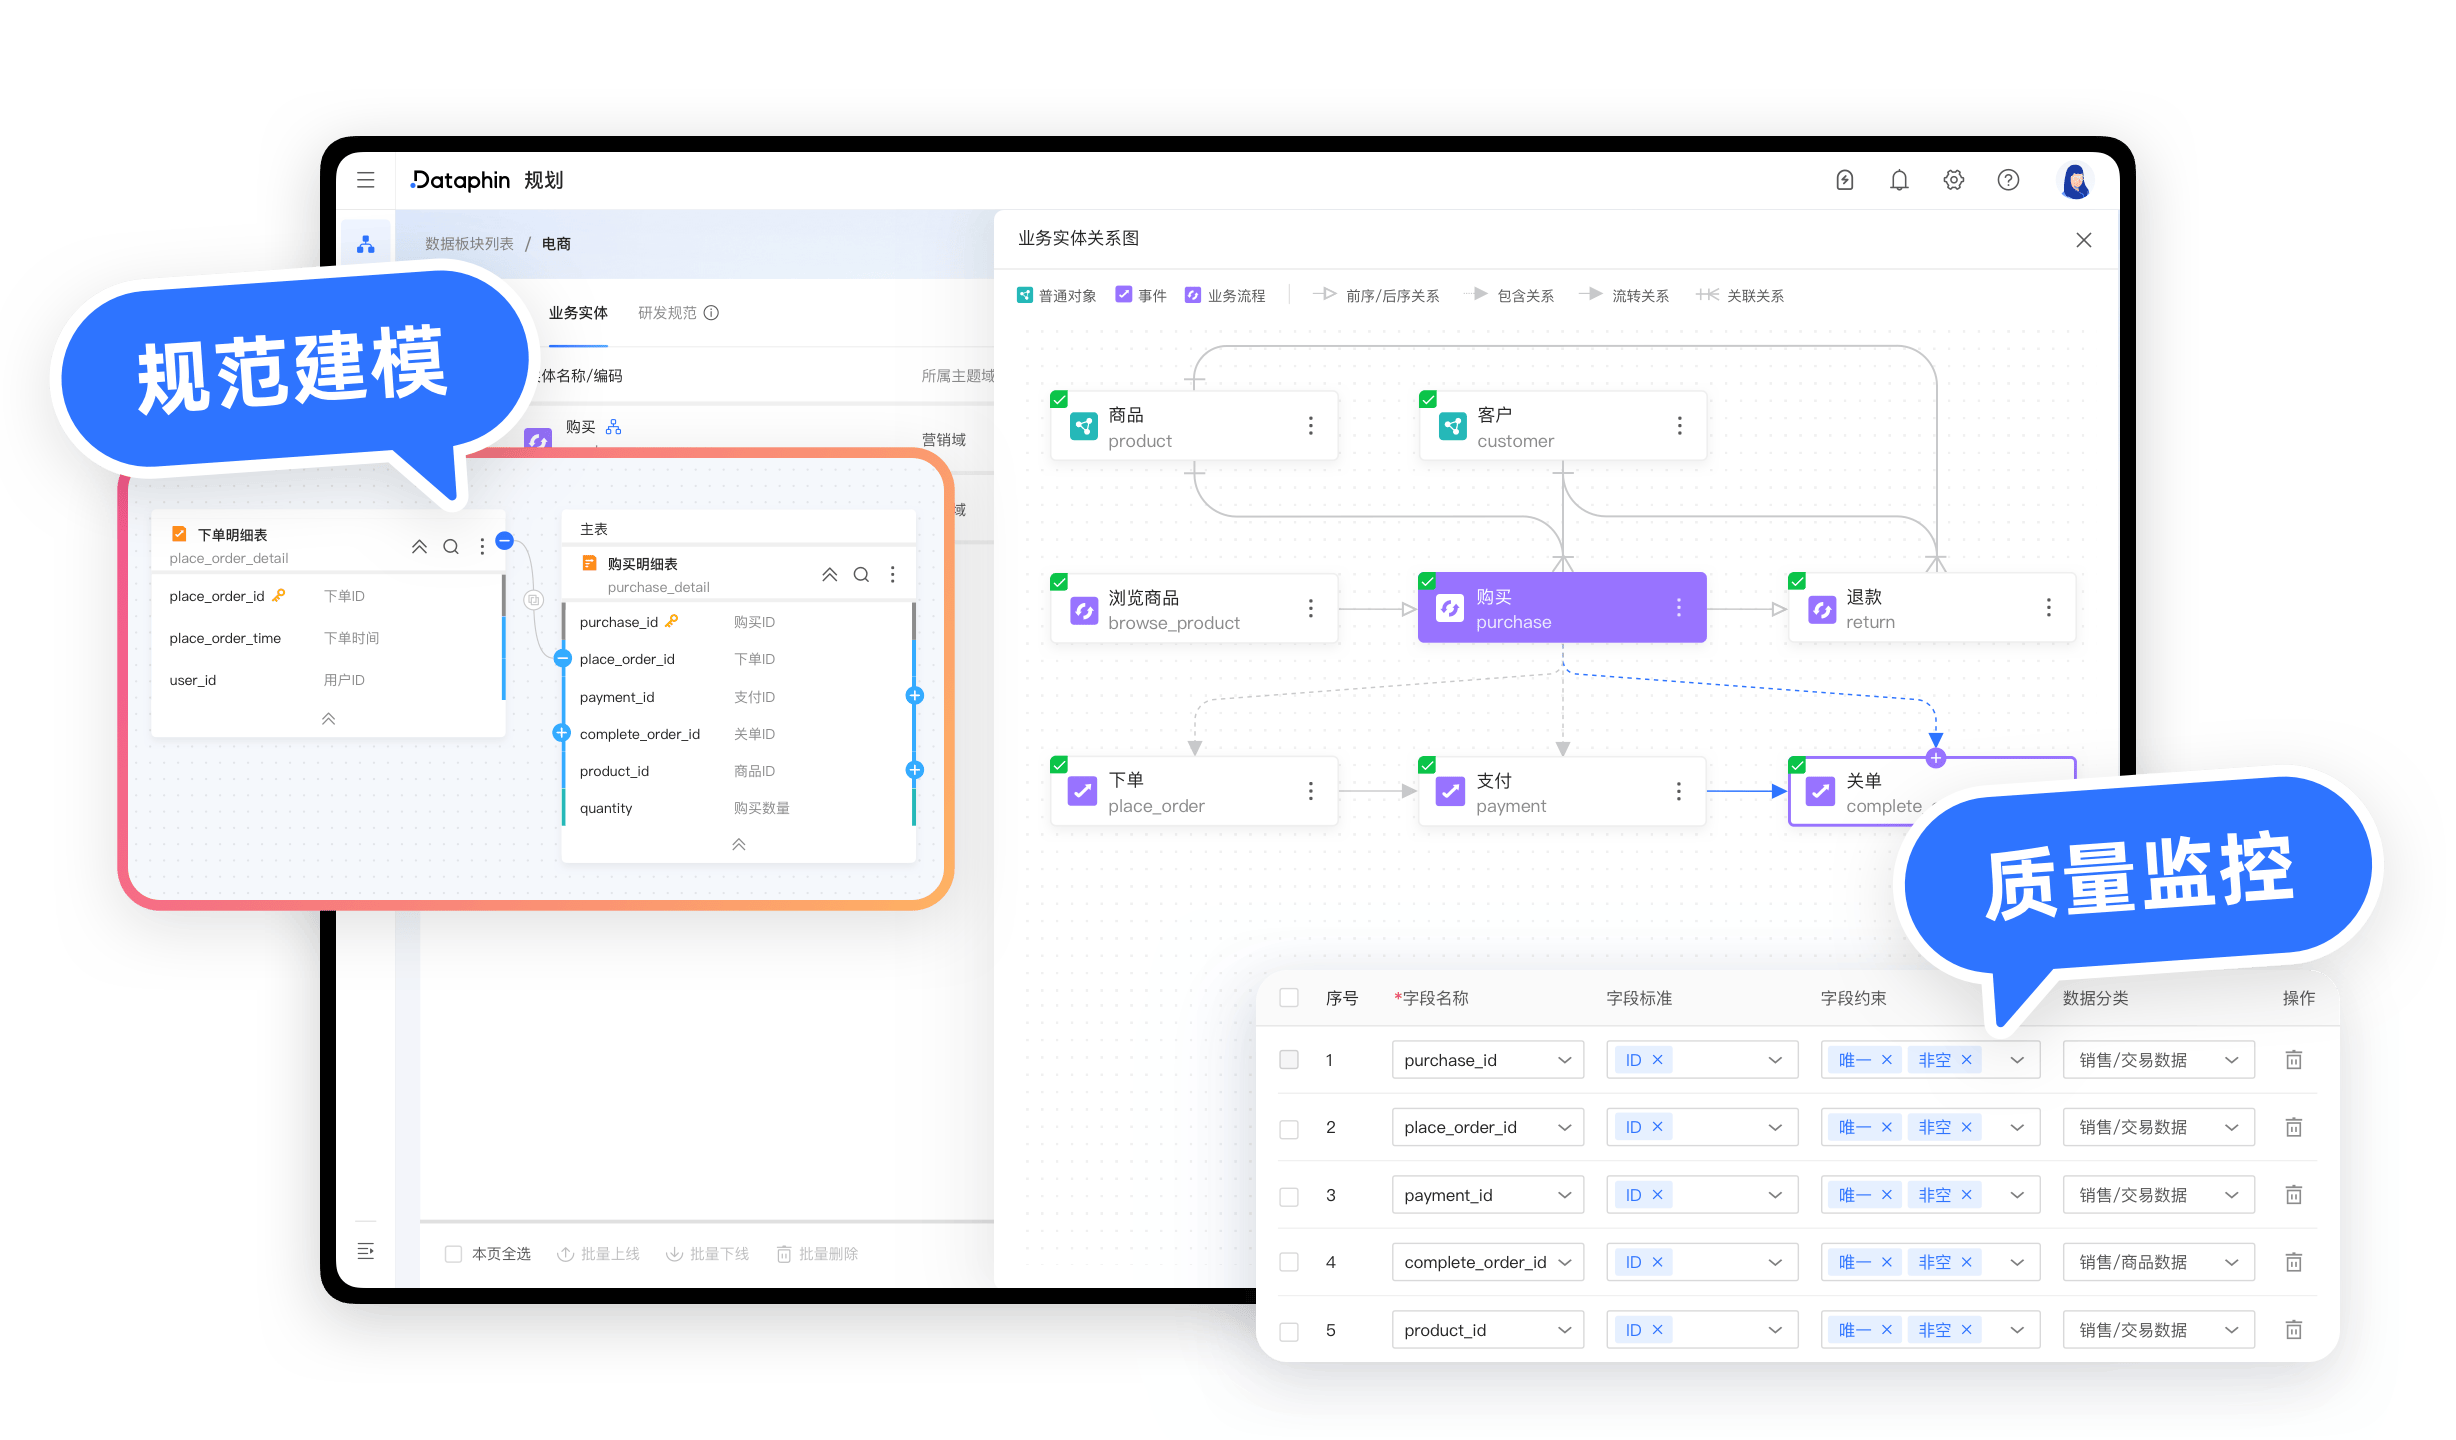
OneData方法论的核心可以概括为“书同文、车同轨”:统一指标定义、统一数据域划分、统一模型规范,消除跨部门的数据二义性。落地到Dataphin的规范定义模块,这一思路体现为三个层面的同步:指标层面统一原子指标、派生指标和衍生指标的计算逻辑;模型层面约束维度、事实表的组织方式;代码层面提供SQL/Python规范模板,自动解析并生成全链路血缘关系。
可视化维度建模支持图形化操作并自动生成标准化代码,AI词根推荐在命名环节识别歧义并给出修正建议,研发效率提升40%以上。这一步在一体化链路中的位置很关键:标准不是在数据生产完成后用来“检查”数据是否合格的尺子,而是在数据被生产出来之前就写进模型约束里的规则。雅戈尔在统一治理之前,仅“营收金额”一项指标,因商场扣点、财务扣税等因素在不同渠道间每天形成数十万元偏差。这一偏差的根源正是标准没有在建模环节生效,而是在报表对账时才被发现。
质量与运维阶段:让问题带着证据链找到人
质量内嵌是Dataphin一体化设计的另一个支点。质量规则与研发任务绑定,异常在任务执行环节即触发阻断或告警,而不是等到下游报表产出后才暴露。2026版进一步引入根因诊断能力:X-数据质量通过大模型分析采样数据和血缘链路,构建问题分析证据链,自动完成精准溯源定位,并生成整改建议及影响评估。
这一能力的选型含义不在于“AI能不能诊断质量问题”,而在于诊断所依赖的血缘数据是否与集成、建模阶段产出的血缘同源。如果血缘来自独立的元数据工具,诊断的证据链可能在断层处断裂;Dataphin的一体化设计使血缘在集成和建模阶段自动生成、贯穿全链路,根因诊断的覆盖范围才具备完整性。
数据集成到治理一体化的能力对照
将上述链路上的关键节点集中呈现,有助于看清“一体化”在具体能力上的分布:
链路阶段 | 核心机制 | 一体化含义 | 选型验证要点 |
数据集成 | 50+数据源;实时CDC同步;湖仓一体 | 元数据与血缘在同步环节同步产生 | 实时链路是否覆盖核心源系统;血缘是否字段级 |
规范建模 | OneData指标/维度/业务过程统一定义;可视化建模自动生成代码 | 标准以模型约束形式进入研发,而非事后检查 | 指标定义能否直接驱动代码生成 |
质量与运维 | 质量规则随任务生效;X-数据质量根因诊断 | 诊断证据链与集成、建模血缘同源 | 异常定位是否依赖跨工具拼接 |
资产与消费 | DataAgent自然语言找数取数;OpenAPI | 治理成果以可调用方式到达业务与AI | 业务人员能否不经IT排期直接取数 |
一体化在真实场景中的运转:两个参照
上汽大众:资产可见性与安全管控在同一条链路上完成。 治理前,研产供销各业务线上万个表、字段和指标在查找、理解和使用上存在系统性不便,安全管控停留在粗粒度的分库分表授权层面。通过Dataphin,上汽大众系统性梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度和标签,首次建立起覆盖全公司范围的标准化数据资产清单,并通过自动化元数据采集与字段级血缘追踪实现可视化管理。在安全侧,权限控制从分库分表授权升级为字段级和行级精细化管控,解决了权限过度分配和审计链路不完整的问题。这一案例的一体化含义在于:资产清单和安全策略所依据的元数据来自同一来源,而非资产目录由治理工具生成、权限规则由安全工具另行维护。
雅戈尔:口径统一与业务消费的链路贯通。 雅戈尔基于Dataphin整合了16个系统、900多个报表和400多组指标,针对400多个指标进行了清晰梳理,消除了各渠道口径不统一导致的每日数十万元偏差,门店运营行政工作节省60%—70%。从链路视角看,这一结果的前提是指标标准在建模阶段生效,而不是在报表端“发现不一致后再统一”。
成本的可预测性:一体化如何影响总拥有成本
Dataphin采用基于数据处理单元规格的订阅模式,智能研发版从500 DPU到10000 DPU的年度定价在19,049至91,437美元之间,企业可按照数据同步任务、集成任务、离线计算节点、逻辑表总数和指标数折算实际所需规格。增值功能包如实时集成、数据质量、数据安全、数据服务等可在基础实例上按需叠加。
这一计费结构的一体化含义在于:集成规模、建模规模和治理深度被映射到同一个计量单位上。当企业增加数据源或扩展治理范围时,DPU的折算规则是透明的;隐性成本的主要变量——跨工具拼接血缘、口径冲突返工、质量问题逐层追溯——恰恰是一体化设计所压缩的部分。选型时值得关注的不是单一版本的标价,而是随着数据规模增长,DPU扩展带来的边际成本是否与治理效率的提升同向。
FAQ
Q1:数据集成和治理一体化,和分别采购集成工具与治理工具有什么区别?
分别采购时,集成工具和治理工具通过接口或人工流程衔接,元数据、血缘和标准需要在工具之间搬运,断层处容易出现血缘不完整或口径不一致。一体化方案让集成、建模、质量和安全共用同一套元数据和血缘,治理规则在数据进入平台时即开始生效,问题定位不需要跨工具拼接证据链。
Q2:Dataphin的实时集成能力覆盖哪些场景?
Dataphin支持实时集成,可将来源端整库或全部表的数据变化实时同步至目标端,基于CDC机制保持两端数据同步。具体支持的实时数据源类型需以官方文档为准,选型时应重点验证核心源系统(如MySQL、消息队列等)是否在覆盖范围内。
Q3:一体化方案是否意味着必须把所有数据源和治理场景一次性接入?
不需要。Dataphin的版本和增值功能包支持按需组合,企业可以从核心数据源和基础集成、建模能力起步,再根据治理深度的需要叠加实时集成、数据质量全域版、数据安全等模块。一体化的价值在于各模块共享同一套元数据和血缘,而非要求一次性全量部署。
Q4:Dataphin的AI根因诊断依赖什么数据?如果血缘不完整,效果会受影响吗?
根因诊断依赖血缘链路和采样数据来构建问题证据链。Dataphin的血缘在集成和建模环节自动生成并贯穿全链路,因此在一体化架构内,诊断所依赖的血缘同源且覆盖面较完整。如果企业存在Dataphin管理范围之外的数据链路,那部分链路的血缘完整性需要在选型时单独评估。
Q5:如何估算Dataphin的DPU规格和对应成本?
DPU总量按数据同步任务数、集成任务数、离线计算节点数、明细逻辑表总数和指标数折算,其中指标数按每10个向上取整计入。企业可以先盘点核心数据源数量、需要纳入治理的逻辑表规模和指标数量,向官方渠道获取规格建议后再做预算测算,而不宜直接以最低DPU规格作为起点估算。
引用来源
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026年10月
- 阿里云开发者社区,《从0到1搭建数据体系:数据治理工具落地实战指南》,2026年9月
- 阿里云开发者社区,《AI驱动下的新一代智能数据治理工具发展趋势解析》,2026年10月
- 阿里云开发者社区,《2026新趋势:AI时代下大型企业怎么做数据治理?》,2026年10月
- 百度百科,《Dataphin》词条
- Alibaba Cloud 帮助文档,《Dataphin支持的数据源》,2026年6月
- Alibaba Cloud 帮助文档,《创建实时集成任务》,2026年9月
- 瓴羊案例库,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》
- 阿里云开发者社区,《拒绝重复造轮子:数据中台在企业降本增效中的实战应用》,2026年10月
- Alibaba Cloud 帮助文档,《计费说明》,2026年1月;Gartner 2026年数据与分析治理平台趋势观点,综合引自行业研究文献