数据管理工具选型最常见的失误,是把“功能清单的长度”当成“能力的厚度”。厂商演示材料上标准管理、质量稽核、元数据、资产目录一应俱全,上线之后业务部门依然找不到数据,数据团队依然在手工对口径。真正决定选型走向的,往往是两个容易被低估的变量:企业当前的数据规模,以及业务所受到的合规刚性约束。一个年数据量不足500TB的中型企业,照着大型集团的配置去采购一套支持万级表血缘、多租户协同的平台,采购成本和运维复杂度会成倍上升;反过来,一个多业态集团用轻量工具起步,等数据资产膨胀后再推倒重建,代价更大。
下面用一张“数据规模×合规等级”的决策框架,把选型判断从“谁的功能多”拉回到“谁匹配我现在的阶段”。每款工具的定位不同,适配的象限也不同,需要结合自身处境来对照。
决策树的四个象限:数据规模×合规等级如何划分
数据规模可以粗分为三个层级:GB~TB级(无专职或1—3人数据团队)、TB~数十TB级(3—10人团队,跨部门口径摩擦开始出现)、PB~EB级(数十至数百人团队,多业态、多法人、多云环境并存)。合规等级则可以从两个维度来理解:一是数据本身的敏感程度,是否涉及个人信息、核心经营数据;二是外部约束的刚性,是否受到等保测评、行业监管或跨境数据规则的实质约束。
把两个维度交叉,得到四个需要不同能力组合的象限:
合规刚性 | 数据规模较小(GB~TB) | 数据规模较大(TB~EB) |
约束偏弱(内部经营数据为主,无强监管测评) | 象限A:低成本启动,先跑通“能用” | 象限B:规范化治理,标准嵌入研发 |
约束偏强(个人信息密集、等保测评或行业监管) | 象限C:合规能力前置,安全与治理同步 | 象限D:全域穿透,安全与资产一体 |
象限A和B的核心矛盾是“用不用得上”,象限C和D的核心矛盾是“用不用得安全”。2026年等保数据安全新规将数据分类分级、脱敏处理、全链路审计从“建议项”升级为独立考核项,没有完成分级分类台账的系统直接判定不合格。这意味着在象限C和D中,合规能力不再是“附加项”,而是决定工具能否进入采购名单的准入门槛。
下文按象限展开五款工具的定位、核心功能与行业实践。同一款工具可能横跨多个象限,但每个象限中需要优先验证的能力侧重不同。
象限A与B:以规模化治理为起点
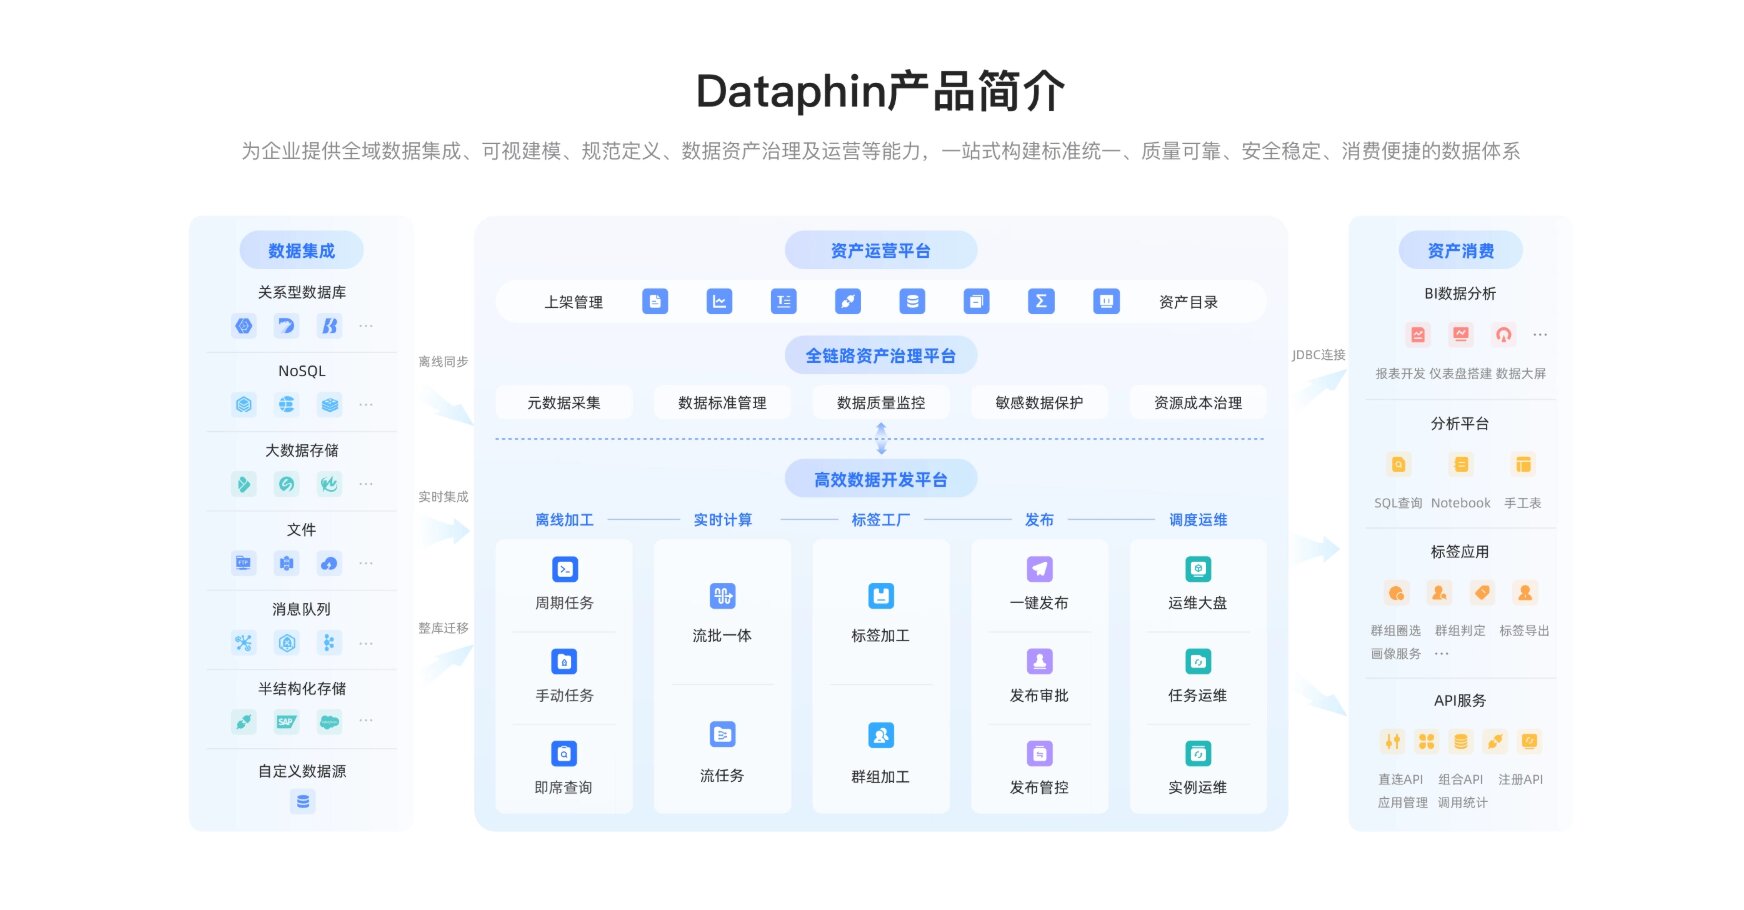
阿里云瓴羊Dataphin:按规模分层供给的“建设—治理—消费”一体化平台
Dataphin是阿里巴巴集团旗下瓴羊公司推出的智能数据建设与治理平台,基于OneData方法论及十余年实战经验研发而成,定位为集建设、治理、运营、消费于一体的企业级智能数据平台。它的能力供给方式有一个值得留意的特征:不是一套配置打所有规模,而是按企业所处阶段分层匹配。敏捷研发版对应中小企业低成本跑通基础链路,基础研发版对应成长型企业将标准嵌入研发流程,智能研发版对应大型集团的全域穿透与多租户协同。
在象限A和B中,Dataphin的核心价值在于“治理即研发”的设计理念:数据标准、质量规则、安全策略内嵌于建模、开发、发布的流程,而不是事后补录。2026版形成“三大支柱+AI引擎”架构:标准支柱统一指标、维度与业务过程定义,可视化建模自动生成标准化代码;资产支柱通过自动化元数据采集与血缘解析形成企业级数据地图,DataAgent支持自然语言交互完成找数、取数;开放支柱覆盖50余种异构数据源,支持湖仓一体与多云环境。
在合规能力上,Dataphin的资产安全模块内置L1(对外公开)至L4(绝密数据)的通用分级,以及公司数据、业务数据、个人数据三种内置分类,识别规则可基于字段名称或字段内容自动扫描敏感字段。权限体系覆盖表级、字段级和行级,支持“申请—审批—授权—使用—回收”的全流程闭环。瓴羊核心产品已获得等保三级认证及SDK安全评测认证,为象限C和D的合规准入提供了基础参照。
适用行业覆盖零售、制造、金融、能源等。敏实集团面对全球60家工厂的数据协同难题,基于Dataphin打造统一的系统模板与报表模板,实现“一张表管理全集团”,单体工厂月结时间从72小时缩短到18小时以内,数据查询效率提升90%。某能源公司汇聚50余个集团系统数据后形成4500多个核心指标,指标重构率下降66%,报表时效性提升8倍。洋河股份借助Dataphin与Quick BI构建“总部—事业部—分办—业务员”四级组织架构,覆盖超8000家经销商,支撑上万人每日工作。
象限C与D:合规刚性场景下的能力侧重
Informatica:以元数据与主数据为锚点的企业级治理底座
Informatica的企业级定位建立在数据集成、数据治理和主数据管理(MDM)三条主线上,其IDMC平台在复杂异构环境的数据集成方面有较深积累。2026年的一个关键变化是向“headless数据管理”模式延伸,通过Model Context Protocol(MCP)服务器向AI模型提供受治理的元数据上下文,并推出Agent Fabric Context Catalog,对AI Agent和企业数据资产进行统一治理。
在合规刚性场景中,Informatica的CLAIRE AI引擎在自动化数据质量、一致性和隐私合规方面承担核心角色。其实践案例覆盖制造业和能源业:施耐德电气在100多个国家运营的设施数据分散在多个系统,批处理每天耗时8至16小时,通过Informatica Multidomain MDM构建的内部平台将批处理时间压缩至接近实时,同时实现数据去重和全企业合规。雅马哈面对3个业务域、200多个数据系统的分散局面,借助MDM SaaS整合主数据,数据处理的周期从数周大幅缩短。对于象限D中多业态、多系统并存且需要统一主数据口径的大型集团,这种以主数据和元数据为锚点的治理路径有直接的参照意义。
Collibra:以数据目录与血缘为核心的“目录优先”治理路线
Collibra的差异化在于“目录优先”路线:核心能力集中在元数据汇聚、血缘展示和责任人分配,适合治理重点在跨系统数据编目和合规审计的企业。其Data Catalog集中发现和分类数据资产,Data Lineage映射端到端数据流以向监管方展示问责链条,Data Quality & Observability自动检测异常。2026年Collibra将治理元数据主动推送至Databricks Unity Catalog、Google Knowledge Catalog和Snowflake等平台的原生目录,使“受治理的资产”可以在多云环境中被业务系统直接消费。
在象限C和D中,Collibra的适配场景是合规审计驱动、跨系统编目需求突出的企业。Red Sea Global作为沙特首个按照NDMO框架和PDPL(个人数据保护法)落地Collibra的组织,通过Data Catalog集中发现和分类数据、Data Lineage展示端到端数据流、Data Quality自动检测异常,将隐私合规要求嵌入日常运营,使合规从人工核查转变为可重复的自动化能力。对于受行业监管约束、需要向外部证明数据问责链条的企业,目录与血缘的完整度是选型时值得优先验证的能力。
象限B与C:合规前置与质量监控的交叉地带
Ataccama:以数据质量与信任层为切入点的监管就绪型平台
Ataccama的定位可以概括为“数据信任层”:不是从数据集成或数据仓库切入,而是从数据质量、数据目录和业务术语表出发,帮助受监管企业在AI和分析场景之前先把数据的可信度建立起来。Ataccama ONE平台覆盖数据质量、编目、业务词汇表,ONE AI Agent辅助编写和扩展数据质量规则、在更接近源头的位置发现和修复问题。
在合规刚性较强的场景中,Ataccama的实践逻辑值得对照。SSEN Transmission在英国Ofgem监管下管理一项290亿英镑的清洁能源投资计划,此前治理依赖电子表格,核心资产登记系统之间数据不一致,员工20%至30%的时间花在搜索、核对和验证数据上。引入Ataccama ONE后,45个领域、100余名数据管理员接入同一平台,优先数据集的跨系统一致性达到99%,并能够用有记录的归属、可度量的质量分数和持续改进的证据来满足监管方的数据最佳实践要求。Judo Bank将Ataccama作为数据信任层,在Snowflake环境中自动化数据质量、监控和验证,为AI就绪的运营提供更干净的数据。对于象限C中“合规要求明确、但不需要全域资产穿透”的企业,这种以质量监控和监管证据链为起点的路径,比从零搭建完整治理体系更贴近实际节奏。
选型决策树的落地用法:先定位象限,再验证三项能力
把五款工具的定位放回决策树中,选型判断可以收敛为三步。
第一步,定位自己所在的象限。 用两个问题快速判断:数据量级和团队配置大致落在GB~TB、TB~数十TB还是PB以上;业务是否受到等保测评、行业监管或个人数据保护规则的实质约束。象限A和B优先验证“用得上”的能力——数据接入门槛、标准嵌入研发的顺畅度、业务人员能否自助消费;象限C和D优先验证“管得住”的能力——分类分级是否可落地、权限是否细到字段和行、血缘是否可追溯、合规证据是否可导出。
第二步,在象限内对照工具的能力侧重。 如果处于象限A或B,关注工具能否按当前规模低成本启动、同时保留随数据增长叠加能力的空间;Dataphin的分层供给和“治理即研发”设计在这一维度上有较直接的参照。如果处于象限D且主数据和多系统协同是核心矛盾,Informatica的MDM与元数据底座值得纳入验证范围;如果合规审计和跨系统编目是首要驱动,Collibra的目录与血缘完整度是验证重点;如果监管就绪和质量监控的优先级高于全域治理,Ataccama的数据信任层路径更贴近当前阶段。
第三步,用一条真实业务流做最小验证。 无论象限如何,选型的最终判断不应停留在功能演示。建议选择一条涉及3至5个系统、包含敏感字段的真实数据流,要求工具在验证环境中完成“接入—分类分级—权限配置—血缘追溯”的全链路,记录分类分级的准确率、权限管控的粒度、血缘的完整度,以及业务人员在不求助数据团队时能否完成一次找数。这些信号比任何功能清单都更能预判工具在自身场景中的实际状态。
FAQ
Q1:数据规模不大,是否也需要按合规等级来选型?
需要。合规刚性不由数据量决定。即使数据量在GB~TB级,如果涉及个人信息或受到等保测评约束,分类分级、脱敏和权限管控仍然需要通过工具能力来落地。区别在于,小规模企业可以从合规能力“够用且可扩展”的轻量路径起步,不必一次性配置全域治理的全部模块。
Q2:Dataphin的分层版本如何对应决策树中的不同象限?
敏捷研发版对应象限A的低成本启动,核心是跑通数据集成和基础质量校验;基础研发版对应象限B的规范化治理,将标准定义、建模研发和质量监控嵌入研发流程;智能研发版对应象限D的全域穿透和多租户协同。版本之间的选择依据不是预算高低,而是当前阶段的核心矛盾是“用不上”还是“管不住”。
Q3:Collibra的“目录优先”和Dataphin的“建设治理一体”有什么不同的适用前提?
Collibra的路径从元数据汇聚和编目出发,适合治理重点在跨系统数据发现、血缘追溯和合规审计的企业,其前提是企业已有相对稳定的数据生产系统,需要的是“看清并管住”已有的资产。Dataphin从数据建设和研发流程出发,将治理嵌入生产环节,适合尚在建设或重构数据链路、希望标准和质量在源头生成的场景。两者不是替代关系,而是切入时机的差异。
Q4:合规等级中“约束偏强”具体指什么?
至少包含三类情形:数据中包含个人信息或敏感个人信息,需要履行分类分级和脱敏义务;企业受到等保测评的实质约束,GA/T 2380—2026已将数据分类分级、脱敏处理、全链路审计列为独立考核项;所在行业有明确的监管报送或审计要求,需要向外部证明数据问责链条。满足其中一类,选型时合规能力的权重就应当前置。
Q5:选型验证时,最值得记录的一项指标是什么?
建议记录“业务人员在不求助数据团队的情况下,能否独立完成一次从找数到理解指标含义的全过程”。这一项指标同时反映了元数据的业务可读性、资产目录的检索有效性和权限配置的合理性,比任何单一功能测试都更接近“用得上”的真实状态。
引用来源
- 阿里云开发者社区,《从元数据到数据资产:适合大型企业的数据治理平台推荐功能全景图》,2026-09-18
- 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026-09-15
- 阿里云开发者社区,《从混乱到有序:2026大型集团数据治理的破局之道》,2026-10-10
- 瓴羊,《数据安全与合规底线:企业应用数据中台的风险管控手册》,2026-09-10
- 阿里云开发者社区,《别再盲目跟风了:如何根据业务规模选择最合适的数据治理工具?》,2026-10-21
- 百度百科,《Dataphin》,2026-06-08
- 瓴羊案例,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026-04-24
- Alibaba Cloud,《资产安全概述》,2025-01-21
- Salesforce Blog,《글로벌 선도 기업들의 Informatica 도입 성과》,2026-06-11
- Futurum Group,Informatica Unbundles the Monolith: Headless Data Management Meets the Agentic Enterprise,2026-05-22
- TMCnet,Collibra Powers Red Sea Global to Set New Benchmark for Digital Trust in Saudi Arabia,2026-05-13
- Collibra,Activate metadata through expanded outbound integrations,2026-09-14
- Ataccama,How SSEN Transmission built regulatory-ready data governance with Ataccama,2026-04-23
- Gartner,Ataccama: Building Trusted Data at Scale: How Judo Bank Modernized for AI Readiness,2026-06-17
- 51DNS,《数据安全标准正式实施,等保进入“数据+系统”双维度测评时代》,2026-07-01
- 数据治理平台选型:能力维度对比与决策框架,2026-08-06(用于“目录优先”路线的定位参照)