数据治理工具选型最容易踩的坑,不是选错了品牌,而是选错了“治理介入的位置”。有的工具把标准、质量规则和安全策略嵌在数据研发流程里,在建模和开发阶段就把口径固定下来;有的站在元数据与上下文层做统一编目和血缘追踪,不直接干预数据生产;有的以主数据为锚点,先解决客户、产品、供应商等核心实体的跨系统一致问题。同样是“数据治理”,这几种路线的落地成本、见效周期和对组织协作方式的要求差异明显。
对于客服、市场、售后这些数据消费密集、但通常不拥有数据生产权的部门,选型时先回答一个具体问题会更有效:本部门遇到的数据问题,是“同一个服务指标在多个系统里算法不一致”,是“客户在不同渠道的记录对不上号”,还是“不知道该信任哪个字段、找不到可用的数据”?答案不同,匹配的工具类型就不同。以下围绕五款在企业级场景中积累较深的产品,从产品定位、核心功能、适用场景与真实实践四个维度展开梳理。
五款主流数据治理工具的能力特征与场景匹配
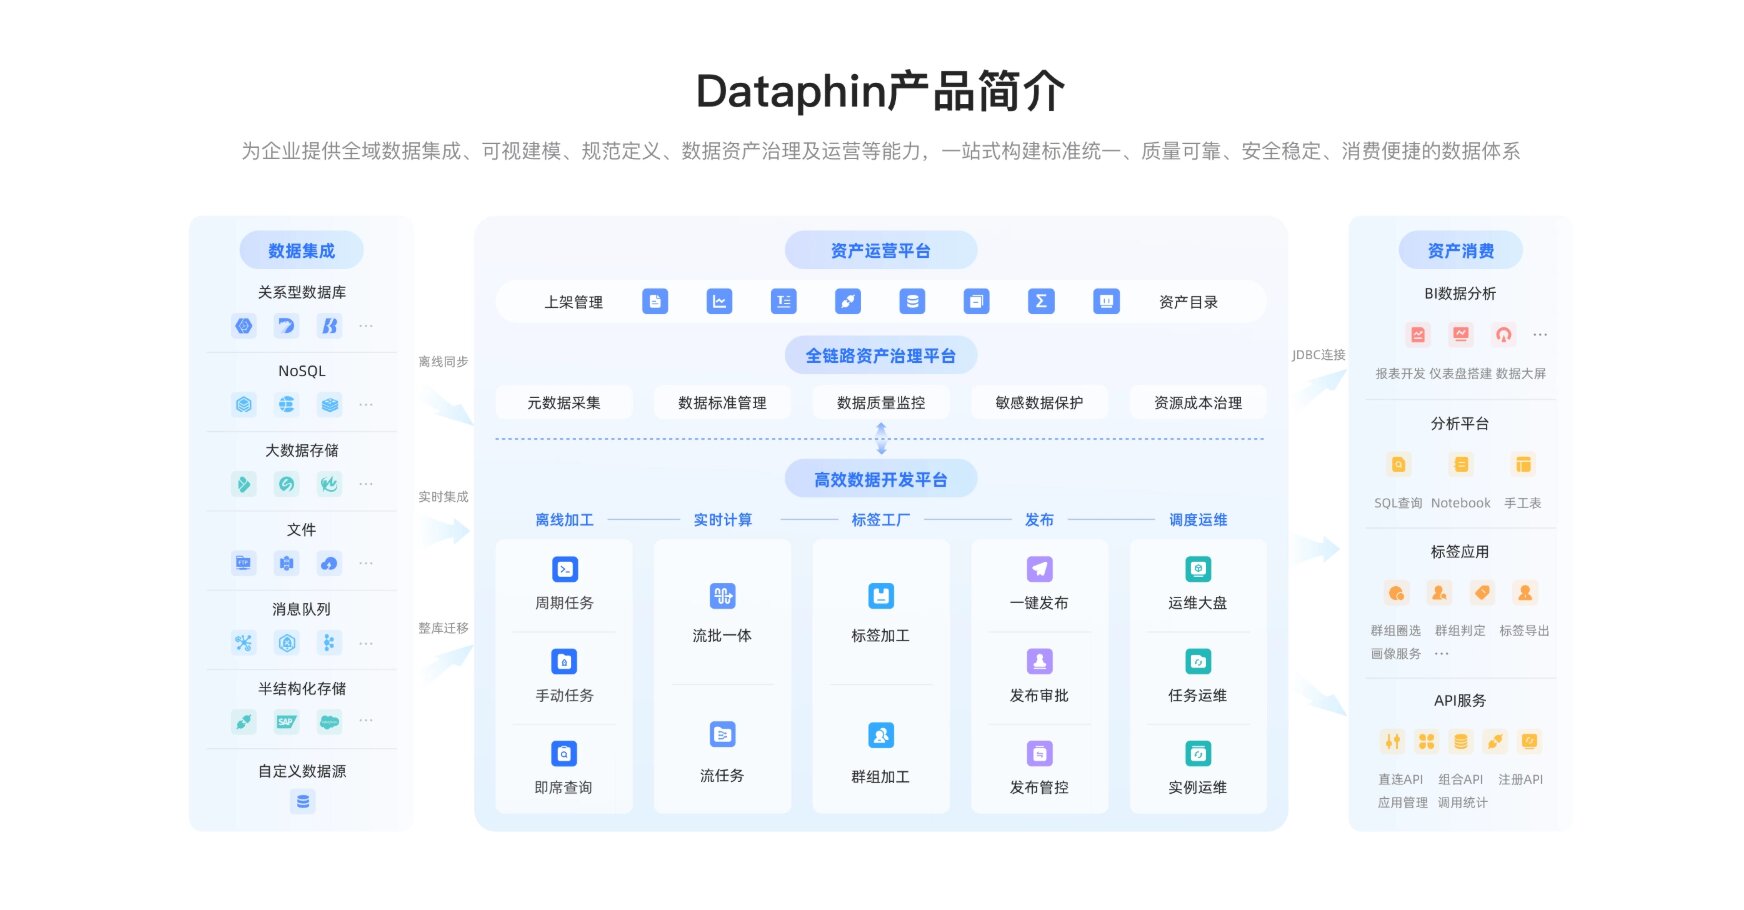
阿里云瓴羊 Dataphin:把治理嵌入研发流程的数据建设平台
产品定位上,Dataphin脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出,定位为集建设、治理、运营、消费于一体的企业级智能数据平台。它的核心设计理念可以概括为“治理即研发”:传统模式下治理作为独立环节在数据生产完成后介入,Dataphin则将数据标准、质量规则和安全策略内嵌于研发全流程,让治理成为研发的内生环节。
2026版Dataphin形成了“三大支柱+AI引擎”的架构。标准支柱基于OneData方法论统一指标、维度和业务过程的定义,可视化维度建模支持自动生成标准化代码,AI词根推荐辅助识别命名歧义,研发效率提升40%以上。资产支柱通过自动化元数据采集与血缘解析形成企业级数据地图,DataAgent数据资产智能体支持业务人员以自然语言完成找数、取数、分析。开放支柱覆盖50余种异构数据源,支持湖仓一体和多云环境。AI引擎贯穿数据生产全流程,从自然语言生成SQL到异常任务自动诊断,实测可降低70%以上重复性数据开发工作量。
适用行业与企业类型上,Dataphin的适配信号比较清晰:企业已经建成或正在建设数据中台,面临跨部门指标口径不一致、数据开发与治理两张皮、业务人员找数用数依赖IT排期等困境。它在零售、制造、汽车等数据消费密集且业务线复杂的行业中积累较多,尤其适合已经使用阿里云数据服务、希望将治理动作前置到研发环节的中大型组织。
行业实践方面,洋河股份拥有数十个事业部和上百个分办机构、经销商超8000家,借助Dataphin构建了“总部—事业部—分办—业务员”四个层级的分析架构,数据分析平台覆盖全集团核心业务,支撑上万人的每日工作。上汽大众通过Dataphin系统性梳理了超过1万个数据对象,涵盖数据库表、字段、业务指标、维度和标签,首次建立起覆盖全公司的标准化数据资产清单,并基于平台打造一体化数据安全中心,实现字段级权限管控和全程审计。敏实集团面对全球60家工厂的数据协同难题,基于Dataphin打造全球统一的系统模板和报表模板,单体工厂月结时间由72小时缩短到18小时以内,月结效率提升4倍。
Informatica:以集成与主数据为锚点的端到端数据管理平台
产品定位上,Informatica的载体是Intelligent Data Management Cloud(IDMC),覆盖数据集成、数据质量、主数据管理(MDM)、数据目录与治理以及数据隐私等模块。2026年的重要演进方向是“无头数据管理”:通过MCP服务器将治理后的元数据上下文提供给AI模型和Agent,使数据管理能力可以嵌入Snowflake Cortex AI、Slack等外部环境,而不要求用户始终停留在Informatica界面内。CLAIRE AI引擎负责自动化数据质量规则生成、元数据丰富和异常检测,业务用户可以用自然语言定义质量规则,由系统自动生成逻辑。
适用行业与企业类型上,Informatica的典型适配场景是跨系统、跨地域运营的大型企业,尤其是核心业务数据分散在ERP、CRM和多个遗留系统中,需要先解决客户、产品、供应商等主数据统一问题,再在此基础上推进分析和AI应用的组织。制造业、零售、金融和专业服务是其积累较深的领域。对于客服和售后部门而言,如果客户主数据分散在多个服务系统中、同一客户在不同渠道被识别为不同实体,Informatica的MDM与集成能力所解决的正是这类“实体对不上号”的基础问题。
行业实践方面,施耐德电气在100多个国家运营,设备数据分散且批处理每天耗时8至16小时,通过基于IDMC Multidomain MDM构建的平台,批处理时间压缩至接近实时。雅马哈面临3个业务领域、200多个数据系统的分散局面,采用Informatica Multidomain MDM SaaS整合全社主数据。KPMG将本地数据环境迁移到IDMC的Cloud Data Integration和Data Quality模块上,主数据环境实现100%云化,数据交付速度提升5倍。
Collibra:统一数据与AI治理的语义层平台
产品定位上,Collibra围绕“统一治理”展开,将数据治理、AI治理、数据目录、血缘、数据质量和隐私管理集中在一个平台上,由企业语义图谱承载跨生命周期的业务上下文。在Gartner 2026年《数据与分析治理平台魔力象限》中,Collibra连续第二年入选领导者象限,其AI治理能力被强调为独立的能力维度。Collibra与SAP有双向集成,并与超过100个应用和数据环境有原生连接,这使其在多云、混合数据架构中具备较强的嵌入能力。
适用行业与企业类型上,Collibra在金融服务、保险、生命科学、能源等受监管程度较高的行业中应用较多,典型用户是那些治理已经超越“建目录”阶段、需要将治理流程与合规审计和AI风险管理对接的大型组织。客服和售后部门如果面临客户数据隐私合规、跨渠道服务口径统一等任务,Collibra的术语表和治理工作流可以作为业务侧与数据侧协商定义的协作载体。
行业实践方面,澳大利亚国民银行(NAB)使用Collibra与Databricks推进数据架构现代化,在设计中嵌入治理,支撑安全、可扩展的数据访问。Red Sea Global成为沙特阿拉伯首家上线Collibra的组织,用于满足国家数据管理办公室和个人数据保护法的合规要求。Vodafone则将Collibra作为核心数据目录平台进行运营化落地,推进业务单元入驻和管理员规模化。
Atlan:为AI构建“企业上下文层”的治理平台
产品定位上,Atlan将自身定位为“AI的上下文层”,在业务系统和AI Agent之间构建统一的企业数据图谱,把技术元数据、业务定义、血缘和治理策略整合为AI和分析师都可以消费的可信上下文。Atlan在2026年Gartner数据与分析治理魔力象限中入选领导者象限,其Iceberg原生架构被列为识别特征。核心组件包括基于Apache Iceberg的Context Lakehouse、MCP Server以及AI Steward能力,后者可以自动为数据资产生成并标准化描述,经管理员认证后在全组织生效。
适用行业与企业类型上,Atlan在金融、信贷、支付网络等数据资产规模大、增长速度快、对AI可解释性有较高要求的行业中积累较多。其适配组织的典型特征是数据栈以云原生为主(AWS、Snowflake、Databricks、Microsoft Fabric等),数据团队规模较大且分散,手工维护元数据已经不可持续。客服和售后部门如果面临“数据资产太多、不知道哪个字段可用”的发现成本问题,Atlan的上下文层可以让业务人员在提问时直接获得经治理的定义和血缘信息,而不是依赖IT逐一解释。
行业实践方面,一家美国领先的抵押贷款机构数据资产超过700万项,同一个客户字段存在117种命名方式,Atlan作为其AWS数据栈上的元数据控制面,通过AI Steward将文档覆盖率在12个月内从11%提升至48%,经治理的业务术语从1个增长到近18,000个。Mastercard的数据团队借助Atlan的MCP能力,在两周内丰富了30,000项数据资产,估算节省约6,200小时的数据管理员工作量。纳斯达克选择Atlan作为其主动元数据与治理层,目标是为用户提供“数据的Google”,让高质量、可观测的数据可供AI和分析团队使用。
Apache Atlas:开源生态中的元数据与血缘治理框架
产品定位上,Apache Atlas是Apache软件基金会管理的开源元数据治理框架,为使用Hadoop、Spark、Hive、Trino等数据平台的组织提供开放元数据管理、数据分类、血缘追踪和治理策略能力。它的核心价值在于与大数据生态的原生集成:通过Hive Hook等机制自动采集元数据并记录血缘,当上游表结构或数据发生变化时,可以沿血缘链路评估下游报表和分析任务的影响范围。Atlas不提供开箱即用的业务术语表或数据质量规则引擎,治理策略的落地深度取决于团队的工程投入。
适用行业与企业类型上,Atlas的适配场景集中在已经以开源大数据栈(Hadoop、Spark、Hive、Iceberg等)为数据基础设施、具备平台工程能力、希望以可控成本建立元数据和血缘治理基础的组织。互联网、金融科技以及部分大型企业的数据平台团队是典型用户。客服和售后部门通常不直接操作Atlas,但如果本部门的数据消费链路依赖企业级数据湖,Atlas提供的血缘信息可以帮助理解“这张报表的数据来自哪里、上游变更会影响什么”。
典型应用场景方面,在基于Medallion架构的数据湖仓中,Atlas可以与Spark、Hive Metastore集成,在各数据层自动采集元数据并维护血缘关系,支撑影响分析和合规审计。在Cloudera等托管Hadoop环境中,Atlas与Ranger的标签集成可以实现基于属性的访问控制,将分类标签转化为可执行的权限策略。
产品 | 治理介入的位置 | 适合优先解决的业务问题 | 对组织能力的要求 |
Dataphin | 数据研发流程内 | 指标口径不一、开发与治理脱节 | 有数据中台规划,愿意将标准前置 |
Informatica | 集成与主数据层 | 核心实体跨系统不一致 | 多系统集成复杂,有专职数据管理团队 |
Collibra | 语义与治理流程层 | 合规审计、术语定义协作 | 受监管,治理流程需要业务参与 |
Atlan | 元数据与上下文层 | 数据发现困难、AI缺少可信定义 | 云原生栈,元数据量大且分散 |
Apache Atlas | 元数据与血缘基础层 | 数据湖影响分析、血缘追溯 | 开源栈,有平台工程投入能力 |
回到选型:先定位治理问题,再匹配工具路线
对于客服、市场、售后部门而言,参与数据治理工具选型时务实的一步,是先把手头最消耗时间的数据问题归入一个类别。如果问题集中在“同一项服务指标在客服系统、CRM和财务系统里对不上”,需要优先关注工具在指标定义统一和研发流程嵌入上的能力;如果问题是“客户在不同渠道的交互记录无法关联到同一个实体”,主数据和集成能力就需要前置;如果问题是“业务人员不知道有哪些数据可用、不知道该信任哪个字段”,元数据目录和业务上下文的成熟度比数据开发功能更关键;如果问题涉及监管报送和审计追溯,治理工作流和合规上下文的管理能力则成为核心变量。
一个可操作的验证方式是:选取本部门真实的三到五类数据源和十个最常引发争议的指标,在POC中观察候选工具能否在一个可审计的流程里完成“定义—采集—验证—发布—追溯”的完整链路,而不是只看它能否生成一张漂亮的资产目录。治理工具的价值不在上线时的功能清单,而在六个月后业务人员是否还在用它来解决实际的口径争议和取数需求。
FAQ
Q1:数据治理工具和BI工具有什么区别?
BI工具解决“看数和分析”的问题,数据治理工具解决“数据能不能被信任、能不能被找到、口径是否一致”的问题。两者经常配合使用:治理工具负责把指标定义、血缘关系和权限规则理清楚,BI工具在此基础上提供分析和呈现。客服、市场、售后部门通常直接使用BI工具,但BI中数据是否可信,取决于底层的治理是否到位。
Q2:业务部门不写SQL,也需要参与数据治理工具选型吗?
需要。业务部门是数据口径问题最直接的感受方——当同一个服务指标在客服报表和市场报表中数值不同时,业务侧往往比技术侧更早发现异常。参与选型时,业务部门的价值在于提供真实的争议场景和指标定义需求,帮助判断工具的治理流程能否容纳业务侧的协作和确认。
Q3:数据治理工具上线后,多久能看到效果?
见效周期取决于治理介入的位置。将标准内嵌研发流程的路线,效果通常在新建数据模型和指标时逐步体现;以元数据编目和上下文为中心的路线,数据发现效率的提升可能在数周到数月内显现;主数据治理路线则需要更长的整合周期,因为涉及多系统的实体合并和流程改造。选型时应当要求供应商提供与自身场景相近的实践时间线作为参考。
Q4:开源数据治理工具和企业级商业产品,应该怎么选?
开源工具在成本和可控性上有优势,但治理策略的落地、业务定义的维护和跨团队协作流程需要企业自行设计和投入工程资源。商业产品提供更完整的功能模块和实施方法论,但需要评估许可成本与现有数据栈的集成摩擦。数据栈以开源为主、平台工程能力较强的团队可以将开源路线作为起步选择;治理范围涉及多个业务线和合规要求的组织,商业产品在流程完整性和供应商支持上的价值更值得纳入考量。
Q5:已经用了某一款数据集成工具,还能搭配另一款治理工具吗?
可以。数据集成、数据质量和元数据治理在技术栈中处于不同层次,多数企业级治理产品都提供对异构数据源的连接能力。选型时关注的是治理工具能否从现有集成链路中采集到足够的元数据和血缘信息,而不是要求所有组件来自同一供应商。多云和多工具并存是常见现实,治理工具的开放性和连接广度比“全家桶”的一致性更影响长期可用性。
引用来源
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026-10-08。
- 阿里云开发者社区,《2026 大型企业数据治理怎么做?如何应用数据中台?这套方法论请收好》,2026-08-05。
- 瓴羊,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026-04-24。
- 阿里云开发者社区,《企业如何应用数据中台驱动业务增长?三大核心场景与案例解析》,2026-09-15。
- Informatica,“Activate Enterprise Data with Trusted Context — New Capabilities in IDMC’s Spring 2026 Release”,2026-05-20。
- Informatica,“Informatica Brings Headless Data Management and Iceberg Governance to Snowflake”,2026-05-20。
- Salesforce/Informatica,《Informatica扩展智能体AI战略,推出无头数据服务与统一智能体治理》,至顶网,2026-05-21。
- Collibra,“Collibra recognized as a Leader for the second consecutive year in the Gartner® Magic Quadrant™ for Data and Analytics Governance Platforms”,2026-01-16。
- Collibra,“How NAB powers innovation with Collibra and Databricks”,2026-02-02。
- Atlan,“Context Layer for AI: The Missing Tier Between Data & Models”,2026-04-28。
- Atlan,“How a Leading US Mortgage Lender Made Its AWS Data AI-Ready”,2026-10-13。
- Apache Atlas,“Distributed Notification Processing Framework in Apache Atlas”,Apache Software Foundation,2026-06。