摘要:中小企业的数据治理困境,常见原因不是“不知道该治”,而是“用不起重武器、养不起专职团队”。轻量级开源工具的价值,在于用可接受的运维投入换取可运行的治理能力。本文先介绍阿里云瓴羊Dataphin敏捷版作为可订阅的轻量起点,再梳理四款在中小企业场景中有明确落地路径的开源数据治理工具,并给出部署落地的步骤参照。
中小企业谈数据治理,常遇到一个错位:治理的必要性已经清楚,但多数方案的设计前提是“有专职数据团队、有独立大数据集群、有持续预算”。客服部门想知道工单数据的口径是否可信,市场部门想确认活动报表的统计逻辑是否一致,售后部门想追溯某张报表的上游变更——这些需求真实存在,但不足以支撑一个重型平台的立项。
“轻量级”因此需要拆成三层来理解:部署轻,不要求先建一套完整的大数据基础设施;运维轻,不需要专人持续盯着平台组件;启用轻,从核心模块开始,而不是一次铺开全部治理域。下文围绕这三个约束,先介绍瓴羊Dataphin敏捷版作为可订阅的轻量路径,再梳理四款在中小企业技术栈中有实际落地空间的开源工具。
一、中小企业的数据治理,先解决“用得起、跑得动”
中小企业的数据环境有一个共性特征:数据源未必少,但技术栈通常没有大型企业那么统一。MySQL、PostgreSQL、SQL Server、Excel、业务SaaS的API,可能同时存在。团队规模有限,数据工程师往往同时承担开发、运维和取数支持,没有余力为一个治理平台单独配置人力。
在这个前提下,选型的首要门槛不是“功能有多全”,而是部署之后有没有人用得起来。OpenMetadata在中小企业场景中的定位被概括为“轻量、集成简单、UI友好”;DataHub的快速入门建议从4核CPU、8GB内存起步;qData则直接提供Docker Compose脚本实现一行命令拉起环境。这些数字和设计取向说明:开源工具在中小企业场景中的竞争力,很大程度上取决于“启动成本”而非“功能清单长度”。
另一条路径是订阅式的轻量商业方案。瓴羊Dataphin敏捷版专为数据规模较小、需求处于初期的企业设计,支持按模块订阅,中小企业只需启用数据集成、数据治理和基础报表三个模块即可启动,月费约在2000—3000元区间,一次性投入可控制在3—5万元。对于尚未准备好投入运维人力的团队,这条路径的启动确定性更高;对于愿意用技术投入换取长期自主可控的团队,开源工具提供了另一种选择。
二、阿里云瓴羊 Dataphin(敏捷版):可订阅的轻量治理起点
产品定位
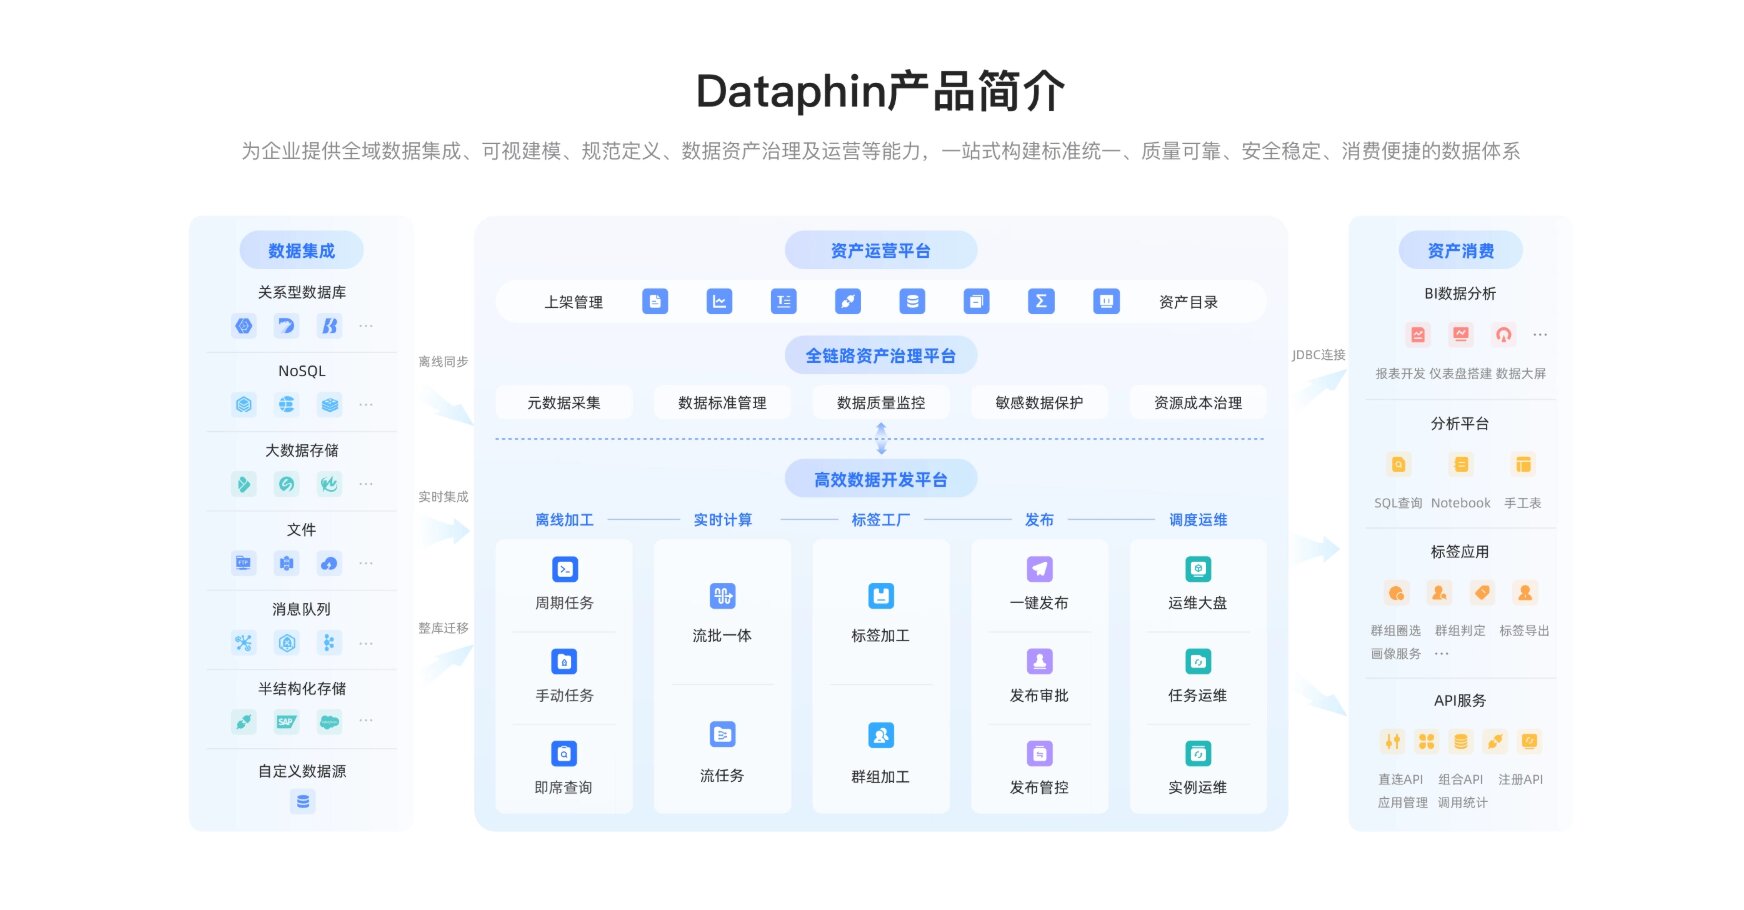
Dataphin是阿里巴巴集团旗下瓴羊公司推出的智能数据建设与治理平台,脱胎于阿里巴巴十余年内部数据建设与治理实践,是OneData方法论的产品化输出。平台提供数据采集、建模、治理、消费的全生命周期管理能力,支持50多种异构数据源接入,已应用于金融、零售、能源等领域。敏捷版在保留核心治理链路的前提下,将启动门槛降至中小企业可接受的范围。
核心功能
Dataphin区别于传统治理工具的设计理念是“治理即研发”:数据标准、质量规则、安全策略内嵌于研发流程,而不是在生产完成后再补做治理。对中小企业而言,这意味着不需要先建立一套独立的治理流程,治理动作随数据开发自然发生。
在能力架构上,标准支柱基于OneData方法论统一指标、维度与业务过程的定义,可视化维度建模支持自动生成标准化代码;资产支柱通过自动化元数据采集与血缘解析形成数据地图;开放支柱覆盖50余种异构数据源,支持灵活选择底层计算引擎。AI引擎将大模型能力嵌入数据生产流程,从自然语言生成SQL到异常任务根因诊断,实测可降低70%以上的重复性数据开发工作量。
适用企业与行业
Dataphin已服务零售、金融、制造、能源等数据密集型行业,案例覆盖从大型集团到成长型企业的多种规模。对于中小企业,以下场景与敏捷版的匹配度较高:客服部门的工单数据与业务系统口径对齐、市场部门的投放数据与财务数据一致性校验、售后部门的备件或服务数据资产化。洋河股份借助Dataphin构建“总部—事业部—分办—业务员”四级数据架构,实现全集团核心业务的数据覆盖与溯源;雅戈尔面对16个系统的数据定义差异,通过统一平台收敛口径。数禾科技作为金融科技领域的成长型企业,通过Dataphin在数据架构、建模和治理维度进行增强管控,数据处理能力提升8倍,数据生产链路实现0事故,全公司近一半同事在日常工作中自主使用平台。这些实践共同指向一件事:治理的价值不在于系统有多重,而在于口径是否统一、链路是否可追溯。
三、OpenMetadata:一体化、开箱即用的治理入口
产品定位
OpenMetadata是一款设计上偏向一体化的开源元数据平台,后端采用Java、前端采用TypeScript,自带完整的Web UI,将元数据管理、数据质量、数据探查和团队协作整合在同一平台中。在中小企业场景中,它的定位是“用尽量少的组件覆盖尽量多的基础治理需求”。
核心功能
平台围绕集中式元数据存储构建,支持数据发现、血缘追踪、数据质量检查和团队协作。内置连接器覆盖主流关系型数据库、数据仓库、BI工具和消息队列,配置后即可采集元数据。对于列级血缘,OpenMetadata提供了原生支持,并且在Iceberg等湖仓场景中有较好的适配。数据质量功能内置于平台之中,不需要额外集成第三方质量引擎。
适用场景与部署要点
OpenMetadata适合希望“一个平台覆盖元数据管理加数据治理”的团队,尤其是数据源跨数据库、BI工具和消息队列的混合环境。官方Docker部署文档要求至少分配6 GiB内存和4 vCPU;社区实践中,小规模生产环境的推荐配置通常在4核8GB或更高。对于10人以下、数据量在10TB以内的团队,8核16GB的配置可以作为中小规模起步的参照。部署方式以Docker Compose为主,适合在单台或少量服务器上完成初始环境搭建。
四、DataHub:以元数据发现和血缘为核心的平台
产品定位
DataHub由LinkedIn开源,2025年1月发布1.0正式版,定位是可编程的元数据平台,核心能力集中在元数据采集、数据血缘追踪和数据发现。它的设计基因来自超大规模数据环境,但在中小企业场景中,快速入门路径已经相对成熟。
核心功能
DataHub通过Kafka实现元数据变更的实时推送,支持对schema变更、数据新鲜度和管道状态的监控告警。它提供GraphQL API和REST API,便于与企业现有的调度、BI或工单系统集成。对于需要追踪“某张报表的字段来自哪个上游表、经过哪些加工步骤”的团队,DataHub的血缘能力是核心价值所在。
适用场景与部署要点
DataHub适合数据技术栈相对复杂、需要实时感知元数据变更的团队。官方快速入门使用datahub docker quickstart一键拉起完整服务栈,基础配置建议4核CPU、8GB内存,生产环境推荐8核16GB。一个务实的边界需要提前明确:DataHub本身不内置数据质量检测引擎,如果治理需求包含质量规则校验,需要集成Great Expectations或自建质量规则。对于质量需求尚不迫切、优先解决“数据在哪里、血缘怎么走”的团队,DataHub的启动路径足够直接。
五、Apache Atlas:Hadoop生态内聚的治理框架
产品定位
Apache Atlas是Apache基金会旗下的数据治理框架,提供集中式元数据管理、数据血缘追踪、基于分类的安全策略和业务术语表管理。它的设计重心在于与Hadoop生态组件的深度集成,在Hive、HBase、Spark、Kafka环境中,元数据采集的配置成本较低。
核心功能与适用场景
Atlas使用图数据库存储元数据关系,复杂血缘查询在技术上较为自然,并提供REST API便于与现有治理流程集成。它适合技术栈以Hadoop体系为主的中小企业:如果现有数据平台已经运行在Hive或Spark之上,Atlas的接入成本相对可控;如果数据环境以云原生数据库或SaaS工具为主,Atlas的生态匹配度会下降。社区活跃度方面,Atlas的迭代节奏较DataHub和OpenMetadata平缓,适合治理需求相对稳定、不追求频繁功能更新的团队。部署上,Atlas的后端依赖HBase、Solr和Kafka,如果已有Hadoop集群,可以复用现有基础设施;如果没有,则需要将这些组件纳入初始部署评估。
六、qData:轻量化、快速启动的开源数据中台
产品定位
qData是一款面向中小企业数据治理与数据研发场景的开源数据中台,设计取向是“轻量化”和“开箱即用”。与传统数据中台深度绑定大数据集群的路径不同,qData不要求企业先具备完整的Hadoop或Spark环境,而是作为一个数据管理与调度的核心层运行,适合数字化转型初期、希望快速完成从数据孤岛到数据资产“从0到1”的团队。
核心功能
qData开源版覆盖数据集成(ETL)、数据开发、数据建模、元数据管理、数据质量、数据资产、API数据服务和AI数据问答等模块。ETL模块支持可视化配置数据接入、清洗、转换和输出,执行引擎可选择DataX或Spark;数据质量模块基于审计规则进行完整性、唯一性和有效性检查;数据服务模块支持将数据表或SQL查询结果封装为RESTful API,减少业务系统取数的定制开发量。
适用场景与部署要点
qData适合预算和运维人力都有限、希望在一个平台上完成“集成—治理—服务”基础闭环的中小企业。官方提供Docker Compose脚本,修改.env配置后一行命令即可拉起整套环境,对于概念验证和初始部署比较友好。在数据规模较小、治理需求集中在基础元数据管理和质量监控的阶段,qData的启动速度是它在中小企业场景中的主要吸引力。
七、场景对照与部署落地步骤
下表从“启动门槛”“治理重心”“部署形态”三个与中小企业直接相关的角度,对上文五款方案做结构化整理。信息仅用于场景对照,不构成优劣判断。
方案 | 启动门槛的典型形态 | 治理重心 | 部署形态的参照 |
瓴羊Dataphin敏捷版 | 按模块订阅,启用集成、治理、基础报表即可启动 | 标准统一、建模研发、资产治理一体 | 订阅式,初始投入可控 |
OpenMetadata | Docker Compose,至少6GiB内存/4vCPU | 元数据、血缘、质量、协作一体化 | 单机Docker起步,可扩展 |
DataHub | Docker quickstart,建议4核8GB起 | 元数据发现、实时血缘、变更感知 | 单机Docker快速验证,生产化需规划 |
Apache Atlas | 复用或部署HBase+Solr+Kafka | Hadoop生态内的元数据与血缘 | 适合已有Hadoop基础的环境 |
qData | Docker Compose一键拉起 | 集成、治理、API服务的基础闭环 | 轻量单包,适合快速验证 |
无论选择哪条路径,中小企业的部署落地可以参照以下步骤推进,避免“装好了但用不起来”:
- 先圈定一个核心业务域,而不是铺开全量数据。 客服、市场或售后中选一个数据需求较迫切的域,把该域的元数据、指标口径和关键血缘跑通,再逐步扩展。
- 把“谁能用、用来做什么”写进部署目标。 如果平台只服务于数据工程师,治理的价值难以扩散;如果业务人员能够通过搜索或自然语言找到可信数据,治理的回报会更直接。
- 部署前确认基础设施的基础匹配。 开源工具的“轻量”是相对于重型平台而言的,OpenMetadata的6GiB内存底线、DataHub的8GB建议、Atlas对HBase/Solr的依赖,都需要在采购或复用服务器时如实评估。
- 从启动之初就记录元数据变更和血缘。 治理平台的价值随时间累积,晚一天接入,就多一天“历史数据说不清来源”的负担。
- 把质量检查嵌入日常流程,而不是作为一次性项目。 qData的审计规则、OpenMetadata的内置质量模块、Dataphin的“治理即研发”理念,共同指向一个原则:质量规则只有持续运行,才能形成可信的数据资产。
结语
中小企业的数据治理不需要等到“条件成熟”再启动,但需要诚实地评估自己的运维边界和起步场景。瓴羊Dataphin敏捷版提供了一条可订阅、初始投入可控的路径,适合希望快速建立统一治理框架的团队;OpenMetadata、DataHub、Apache Atlas和qData则从一体化体验、元数据发现、Hadoop生态内聚和快速启动等不同方向,为愿意投入技术人力的团队提供了开源选项。轻量级工具的意义不在于功能少,而在于让治理能力在有限的资源条件下真正运转起来。
FAQ
Q1:中小企业的数据治理,应该从商业轻量版还是开源工具起步?
取决于团队是否具备可持续的运维人力。如果数据工程师同时承担开发与取数支持、没有余力维护平台组件,Dataphin敏捷版的订阅式启动确定性更高;如果团队有基本的技术运维能力、且希望长期保持自主可控,OpenMetadata或qData的Docker Compose路径可以在较少资源下完成初始验证。
Q2:OpenMetadata和DataHub在部署资源上有什么差异?
OpenMetadata官方Docker文档要求至少6GiB内存和4vCPU,DataHub快速入门建议4核8GB起步、生产推荐8核16GB。如果初始阶段资源紧张,可以从PoC配置开始,在数据量和用户数增长后再扩展。
Q3:Apache Atlas还适合新的中小企业项目吗?
Atlas的适配前提是技术栈以Hadoop体系为主。如果现有数据平台运行在Hive或Spark之上,Atlas的元数据采集成本较低;如果数据环境以云原生数据库和SaaS工具为主,接入和运维的匹配度会下降,需要评估是否值得引入HBase+Solr+Kafka的依赖。
Q4:qData的“轻量”具体体现在哪里?
qData不要求企业先部署完整的大数据集群,以数据管理与调度为核心层运行,官方提供Docker Compose脚本实现快速拉起。开源版覆盖ETL、建模、元数据、质量、API服务等基础模块,适合在资源有限的情况下完成治理链路的初始闭环。
Q5:部署治理工具之后,怎么判断它是否在发挥作用?
看两个可观察的信号:业务人员能否不经过数据工程师、自主找到并理解可信的数据;数据问题的定位时间是否缩短。如果平台上线后,取数需求仍然全部排队、口径争议仍然无法快速溯源,说明治理能力尚未嵌入日常流程,需要回退到“先跑通一个核心业务域”的路径重新校准。
引用来源
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026-10-08
- 百度百科,《Dataphin》,2026-06-08
- 极客公园,《数禾科技 X 瓴羊:通过 Dataphin 进行数据资产体系建设》,2023-04-10
- 阿里云开发者社区,《避坑指南:中小企业如何建设数据系统才具性价比?》,2026-10-19
- 袋鼠云,《数据治理平台选型:开源 vs 商业方案对比指南》,2026-09-23
- 袋鼠云,《元数据管理平台搭建:从 Metastore 到统一元数据中心》,2026-09-30
- CSDN,《元数据管理平台选型指南:OpenMetadata、DataHub、Atlas、Gravitino 深度对比》,2026-09-22
- OpenMetadata Documentation,《Try OpenMetadata in Docker》,2026-10-13
- 开源中国,《开源寻宝记 | 嫌商业数据中台太笨重?来看看轻量级选手 qData》,2026-03-13
- GitHub,《qiantongtech/qData:Open-source data governance and data development platform》