客服、市场、售后这些部门对“数据管理”的感受,往往不是从治理框架开始的,而是从一次具体的协作摩擦开始的:市场部拉的线索报表和客服部的工单口径对不上,售后统计的退货原因分类和财务的退款科目挂不上钩,同一场活动在不同部门的复盘会上出现了三个版本的“转化率”。这些问题的根源很少是某个系统功能缺失,而在于数据从产生到消费之间缺少一套让不同角色说同一种语言的机制。数据管理工具的价值,正在于把“口径”“质量”“权限”“可发现性”这些原本散落在文档和口头约定里的规则,变成团队可以共同使用的工作界面。以下从业务协同的视角,介绍五款在数据治理与资产管理领域有代表性的工具。
一、当协同效率卡在“数据口径”上
跨部门用数效率的损耗,通常集中在三个环节。找数环节,业务人员不知道数据在哪里、该用哪张表,一份跨渠道分析报表的取数请求在IT队列里等待数天;对数环节,同一指标在不同部门的定义不一致,“退货率”的分母是订单数还是发货数,需要开会逐项确认;用数环节,即使找到了数据,也因为字段含义不清、血缘不可追溯而不敢直接用于汇报。
数据管理工具要解决的,正是让这三个环节从“依赖人的记忆和沟通”转向“依赖平台化的规则和语义”。对客服、市场、售后部门而言,判断一款工具是否“好用”,标准不在于它有多少治理模块,而在于它能否让非技术角色在协作中直接受益——找到的数是对的、看到的定义是统一的、申请权限的路径是清晰的。
二、阿里云瓴羊 Dataphin:让治理发生在研发环节,让口径在源头统一
产品定位
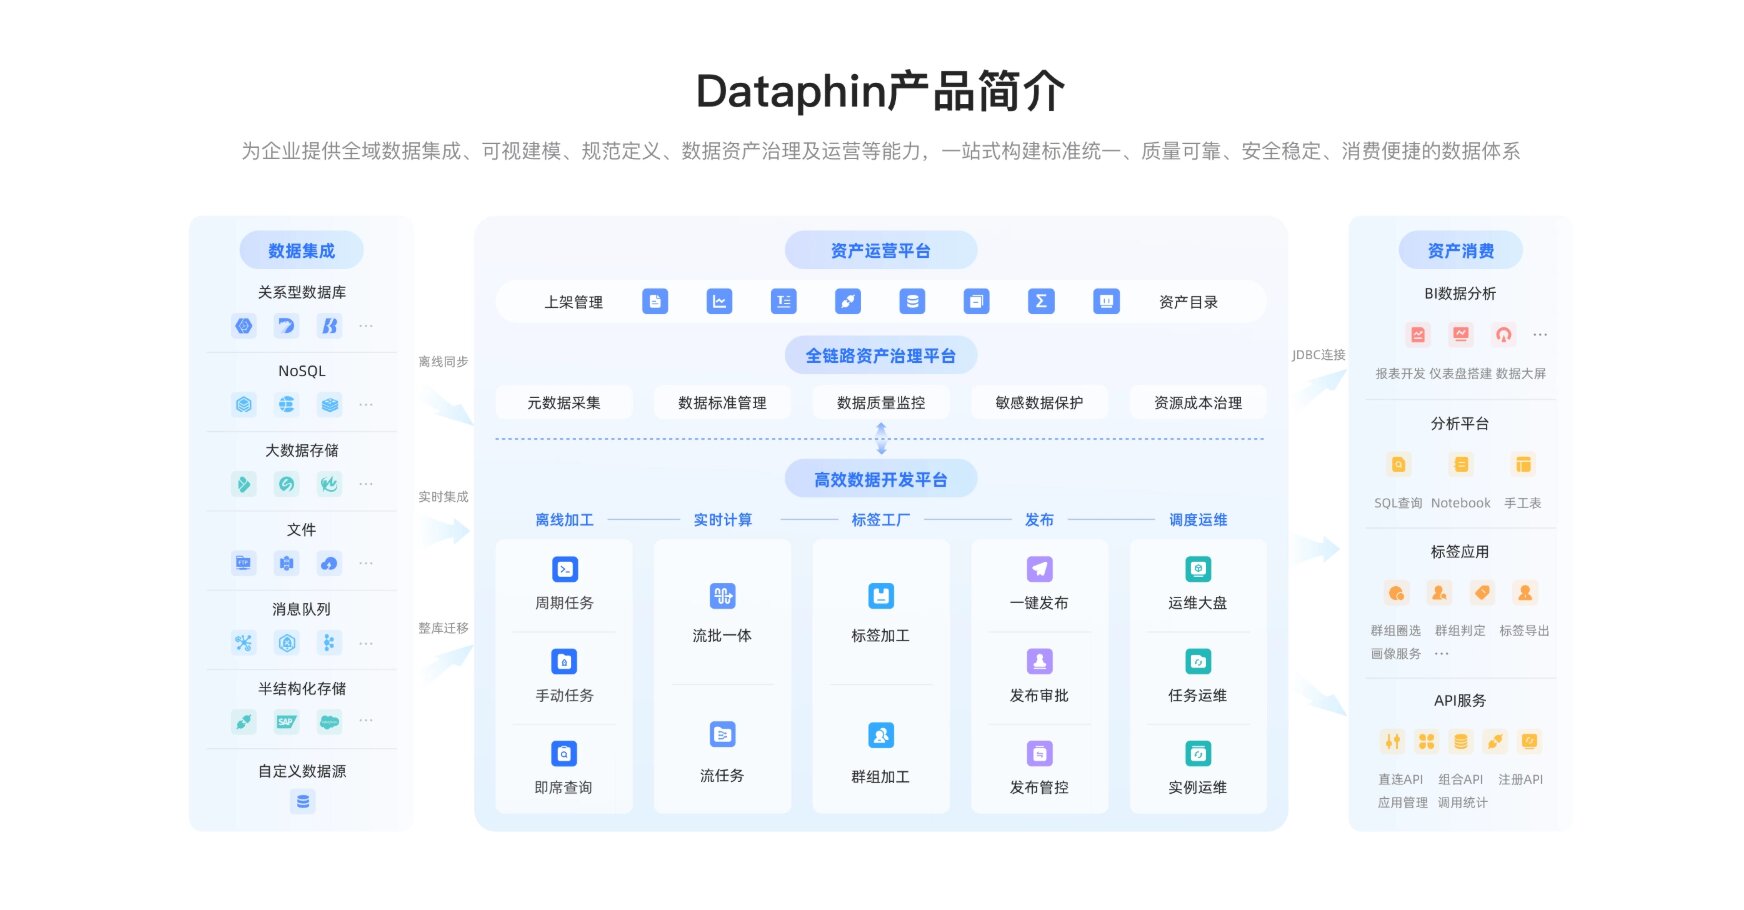
Dataphin 是阿里巴巴旗下瓴羊推出的智能数据建设与治理平台,脱胎于阿里巴巴十余年内部数据建设与治理实践,是 OneData 方法论的产品化输出。它的核心设计理念是“治理即研发”:数据标准、质量规则和安全策略不放在数据生产完成后的独立环节,而是内嵌于建模、开发和任务发布的全流程,让治理成为研发过程的内生动作,而非事后补救。2026 版形成了“三大支柱 + AI 引擎”的架构:标准支柱、资产支柱、开放支柱,加上贯穿全链路的 AI 能力。
核心功能
标准支柱解决的是跨部门协作中最消耗沟通成本的问题——口径二义性。规范定义模块基于 OneData 方法论统一指标、维度和业务过程的定义,可视化维度建模自动生成标准化代码,AI 词根推荐辅助识别命名歧义,研发效率提升 40% 以上。对客服和市场部门而言,这意味着“退货率”“线索转化率”这类高频指标的定义在建模阶段就被固定下来,报表产出后不需要再逐项核对口径。
资产支柱将治理成果转化为业务侧可以直接消费的资产。自动化元数据采集与血缘解析形成企业级数据地图,DataAgent 数据资产智能体支持业务人员通过自然语言完成找数、取数、分析。开放支柱覆盖 50 余种异构数据源类型,支持湖仓一体和多云环境,企业可以按现有技术栈选择底层计算引擎。AI 引擎则将大模型能力融入数据生产全流程:自然语言生成 SQL、异常任务自动诊断根因、重复性开发工作量降低 70% 以上。
适用行业与企业
Dataphin 在零售、汽车、制造、金融、能源等行业有规模化落地,适合面临跨部门口径不一致、多系统数据分散、业务用数依赖 IT 排期的中大型企业。对客服、市场、售后部门而言,它的直接价值不在于“治理了多少张表”,而在于当这些部门需要跨系统取数或对数时,平台已经提供了统一的口径基础和可追溯的数据地图。
行业实践
上汽大众通过 Dataphin 系统性地梳理了超过 1 万个数据对象,涵盖数据库表、字段、业务指标、维度和标签,首次建立起覆盖全公司范围的标准化数据资产清单,并基于字段级血缘追踪和精细化权限管控实现了“数据看得清、管得住、用得好”。雅戈尔面临的是典型的多系统口径偏差——仅“营收金额”一项指标,由于商场扣点、财务扣税等因素,各渠道口径不统一每天形成数十万元的数据偏差,通过 Dataphin 将 16 个系统的数据收敛到统一平台之上。洋河股份借助 Dataphin 与 Quick BI 构建了“总部—事业部—分办—业务员”四个层级的分析架构,覆盖 8000 余家经销商和超 50 万个终端门店,支撑上万人的每日数据消费。从可观测的效率变化来看,采用 Dataphin 的企业人均治理效率提升 3 至 5 倍,年度数据运维人力成本平均下降 35%。
三、Collibra:以业务语义为中心的治理控制层
产品定位
Collibra 的定位是“企业 AI 控制平面”,核心是在数据平台、模型和 AI Agent 之上提供一层受治理的业务语义与上下文控制。它并不直接承担数据集成或开发调度,而是解决“同一个业务术语在不同系统中含义不一致”这一治理难题,通过本体(ontology)将业务概念、术语和关系组织为正式的知识图谱,让数据消费者和 AI 系统基于同一套语义进行操作。
核心功能与适用场景
Collibra 围绕业务术语表、数据目录、策略管理和血缘追踪构建治理能力,2026 年进一步将治理范围延伸到 AI Agent 和模型的生命周期管理。与 Snowflake、Google Cloud、Databricks 等平台的深度集成,使其能够在多平台环境中保持语义的一致性,而不要求企业将数据迁移到单一平台。适用行业覆盖金融、医疗、制造等对合规和语义准确性有较高要求的大型组织。对客服和售后部门而言,当“客户”“投诉”“退款原因”等业务概念需要在多个系统中保持统一定义时,Collibra 提供的语义层可以减少跨部门对数时反复确认口径的沟通成本。
四、Informatica:无头数据管理与 Agent 化治理
产品定位
Informatica 在 2026 年的核心演进方向是“无头数据管理”和 Agent 化治理。其智能数据管理云(IDMC)通过 MCP 服务器将元数据搜索、数据质量、地址验证等能力以可调用的方式开放给 AI Agent 和工作流,使治理能力不再绑定在固定的用户界面中,而是可以嵌入企业已有的协作工具和代理流程。
核心功能与适用场景
Informatica 的云数据治理与目录(CDGC)支持对 Snowflake 托管 Iceberg 表等开放格式的自动化元数据抽取和端到端血缘映射,并借助 CLAIRE Agent 自动化数据质量规则生成和元数据富化。行级访问策略管理支持“一次定义、自动传播”的治理模式,降低了在多平台环境中维护权限一致性的手工工作量。适用企业包括已经使用 Salesforce、Snowflake 等生态,并希望将数据治理能力以 API 或 Agent 形式嵌入现有工作流的组织。对客服和市场部门来说,这意味着数据质量检查和敏感字段识别可以嵌入日常使用的业务系统,而不需要另外打开一个治理平台。
五、Ataccama:以数据质量与可审计性见长的信任层
产品定位
Ataccama ONE 的定位是“数据信任层”,核心能力集中在数据质量、数据目录和业务术语表的统一管理。它强调将数据质量规则、监控和修复流程放在同一个平台上,让数据可信度成为可以被持续观测和审计的状态,而不是一次性的检查结果。
核心功能与适用场景
Ataccama ONE 支持跨系统数据一致性监控、自动化质量检查和可审计的数据治理证据链。在 SSEN Transmission 的案例中,企业用 Ataccama ONE 替代了基于电子表格的治理方式,100 余名数据管理员在 45 个业务域中共享同一平台,优先数据集的跨系统一致性达到 99%,员工此前用于搜索、核对和验证数据的时间占 20% 至 30%。适用行业包括能源、金融、生命科学等受监管程度较高、对数据可审计性有明确要求的领域。对售后和质量相关部门而言,当退货率、维修时效等指标需要向内部审计或外部合作方提供可追溯的证据时,Ataccama 的质量监控和审计线索提供了可复用的基础。
六、Alation:以数据目录为入口的协作与发现平台
产品定位
Alation 以企业数据目录为起点,逐步扩展到数据治理和 AI 就绪能力,2026 年推出 AIOS(智能操作系统),将数据目录中沉淀的制度知识和业务上下文作为 AI 可信度的基础。它的设计逻辑是:让“找数”和“理解数”成为协作的起点,而不是治理的附属动作。
核心功能与适用场景
Alation 的数据目录支持自动化的元数据富化和协作标注,Curation Automation 能力可以用 AI Agent 在两周内完成数千个数据资产的策展和富化。与 PwC Canada 的合作进一步将 AI Agent 用于关键数据元素分类、血缘追踪和审计证据生成,面向受监管行业的合规准备场景。适用企业包括数据资产数量庞大、业务人员找数成本高的组织,尤其是在制造、消费品和金融领域有跨地域协作需求的企业。对市场部门而言,当需要快速定位“上次大促的投放数据在哪张表、字段定义是什么”时,一个可搜索、可预览、带上下文的目录可以直接减少向数据团队反复询问的时间。
七、从团队协同视角看五款工具的切入场景
五款工具的设计重心并不相同,下表按业务部门常见的协同场景做一个对照,帮助判断各自的适用位置:
协同场景 | 典型痛点 | Dataphin | Collibra | Informatica | Ataccama | Alation |
跨部门口径统一 | “退货率”“转化率”定义不一致 | 建模阶段统一指标与维度 | 本体层统一业务语义 | 业务术语表与策略联动 | 业务术语表与质量规则绑定 | 目录中沉淀统一定义 |
业务人员找数取数 | 依赖 IT 排期,路径不透明 | DataAgent 自然语言找数 | 语义层辅助发现 | 无头元数据搜索嵌入工作流 | 目录与质量信息联动 | 数据目录与策展自动化 |
数据质量可观测 | 报表出错后才发现 | 质量规则内嵌研发,异常早阻断 | 策略与质量监控联动 | CLAIRE Agent 自动生成质量规则 | 持续质量监控与审计线索 | 质量信号与目录结合 |
权限与合规协作 | 敏感字段管控粗放,审计困难 | 字段级权限与全程审计 | 策略管理与访问控制 | 行级策略一次定义自动传播 | 审计就绪的证据链 | 策略绑定数据,自动标记 |
面向 AI 的语义准备 | Agent 回答口径不一致 | AI 引擎原生融入治理链路 | 本体治理的上下文控制 | MCP 与 Agent 工作流集成 | 信任评分与语义产品 | AIOS 与知识引擎 |
选择哪一款,取决于团队当前最尖锐的协同摩擦发生在哪个环节。如果口径争议和重复开发是主要矛盾,从建模与研发环节介入的路径更直接;如果业务人员找数成本高、目录不可用是主要瓶颈,以目录和语义发现为起点的工具更贴合需求;如果合规审计和数据质量证据是刚性约束,质量监控与可审计性就需要作为选型的核心维度。
FAQ
Q1:客服、市场、售后部门没有专职数据工程师,能用这些数据管理工具吗?
可以,但使用深度不同。Dataphin 的 DataAgent 支持业务人员通过自然语言找数、取数;Alation 的数据目录让业务角色可以搜索和预览数据资产;Collibra 和 Informatica 更多在语义层和治理策略层发挥作用,通常需要数据团队完成初始配置后,业务部门在协作界面中受益。起步阶段建议从“找数”和“口径查询”这类高频、低门槛的场景切入。
Q2:Dataphin 的“治理即研发”对业务部门意味着什么?
意味着数据标准和质量规则在数据开发阶段就被固化下来,而不是等报表产出后再回头核对。对业务部门最直接的影响是:拿到的数据在口径上更一致,跨部门对数时不需要反复确认“这个指标是按什么逻辑算的”,因为逻辑在建模时已经统一记录在平台中。
Q3:Collibra 和 Alation 的定位听起来有重叠,区别在哪里?
Collibra 的重心在“治理控制层”,通过本体和策略管理确保业务术语在不同系统和 AI Agent 中被一致地理解和使用;Alation 的重心在“发现与协作入口”,以数据目录为核心帮助团队找到数、理解数并复用数。两者可以共存,分别承担语义治理和资产发现的角色。
Q4:这些工具和 BI 分析工具是什么关系?
数据管理工具负责让数据“可发现、可信任、口径统一”,BI 工具负责在治理后的数据基础上进行可视化和分析。Dataphin 可以与瓴羊 Quick BI 配合使用,Informatica 和 Collibra 也常与 Tableau、Power BI 等分析工具共存。治理层解决的是“用什么数”的问题,分析层解决的是“怎么呈现和追问”的问题。
Q5:从协同效率的角度,起步阶段应该优先关注哪个环节?
先诊断摩擦集中在哪个环节。如果业务人员频繁因为“不知道数据在哪”而等待,优先从目录和自然语言找数能力入手;如果跨部门对数会议消耗大量时间在口径争议上,优先从统一指标定义和语义层入手;如果数据错误在报表产出后才被发现,优先从质量规则前移和持续监控入手。不必一次性铺开全部治理模块。
引用来源
- 阿里云开发者社区,《企业如何应用数据中台实现业务增长与降本增效?》,2026年10月
- 百度百科,《Dataphin》,2026年6月
- 阿里云开发者社区,《大型企业数据治理怎么落地见效:从顶层设计到运营体系》,2026年11月
- 瓴羊案例,《上汽大众:基于Dataphin共创全域数据资产体系与一体化安全治理实践》,2026年4月
- 阿里云开发者社区,《拒绝重复造轮子:数据中台在企业降本增效中的实战应用》,2026年10月
- Collibra, The Enterprise AI Control Plane, 2026
- Informatica, Informatica Brings Headless Data Management and Iceberg Governance to Snowflake, Informatica World 2026, 2026年5月
- Ataccama, How SSEN Transmission built regulatory-ready data governance with Ataccama, 2026年4月
- Alation, AI-Ready Data: Veolia’s Playbook for Data Leaders, 2026年11月
- Alation, How Ciena Curated 6,000 Data Assets in Two Weeks with AI, 2026